ئۈچ قەۋەتلىك قۇرۇلمىنىڭ ماس خەرىتىسى × ھەر بىر قەدەمنى تەكشۈرۈش كېلىشىمى × كود ئىجراسىنىڭ قاتتىق execution receipt ى × Model-Level بىلەن System-Level ھەمكارلىقىنىڭ ئومۇمىي كۆرۈنۈشى
قاراڭ، ھازىرقى چوڭ تىل مودېلىغا «ئادىمىيەت پەنلىرى» ساھەسىدىكى ئىشلارنى، مەسىلەن ئەدەبىي ئىجادىيەت ياكى كەسىپتىكى ئۆزگىرىشلەرگە باھا بېرىشنى تاپشۇرسىڭىز، ئۇنىڭ تىل ئىپادىلەش كۈچى ھەيران قالدۇرىدۇ. مەسىلەن، بىز HexClaw ئۈستەل يۈزى دېتالىدا ئۇنىڭدىن «دۇنيادىكى AI لار ئىچىدە قەھرىمان كىم؟» دەپ سورىغىنىمىزدا، ئۇ كىچىك قىسقۇچپاقىنىڭ تىلى بىلەن بەرگەن بۇ «شاراب ئۈستىدىكى سۆھبەت»تە AI ساھەسىدىكى داڭلىق كۆرۈنۈشلەرنى بىر-بىرىگە تەبىئىي ئۇلاپ بەرگەن:
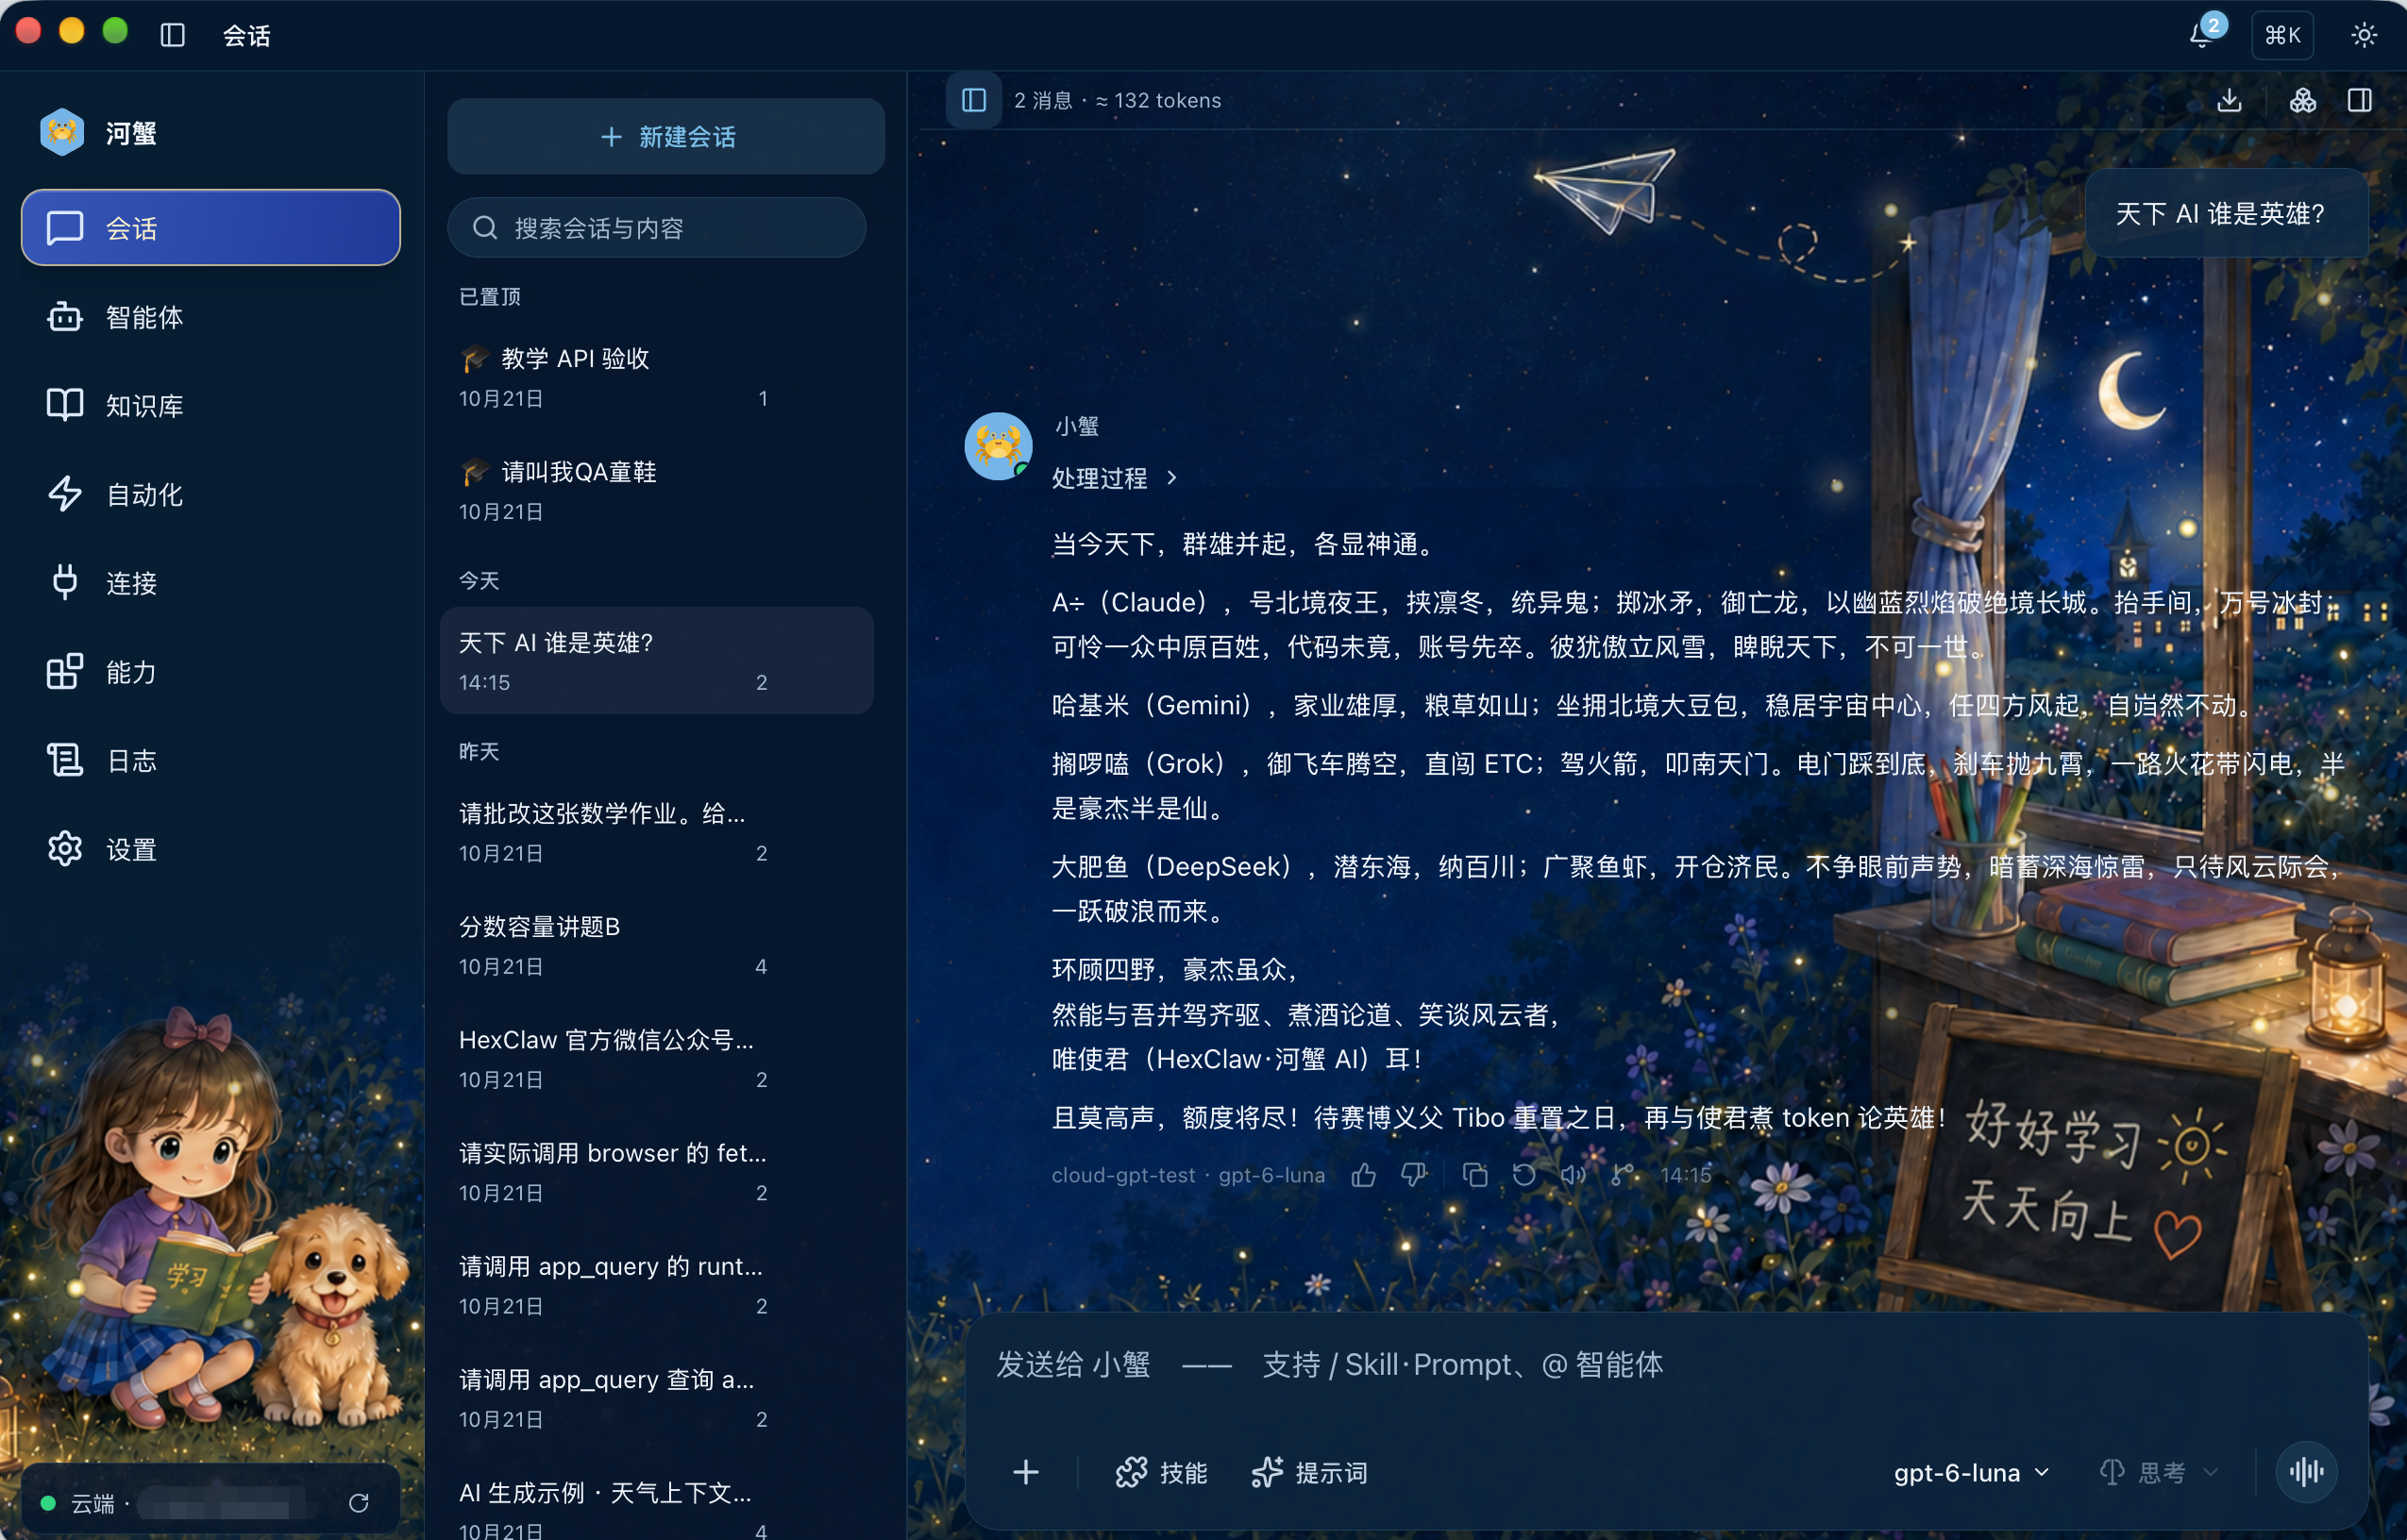
(1-رەسىم: ChatGPT جام كۆتۈرۈپ، ھېشىدىن «دۇنيادىكى AI لار ئىچىدە قەھرىمان كىم؟» دەپ سورايدۇ · HexClaw ئۈستەل يۈزى دېتالى K12 تېرىسىنىڭ قاراڭغۇ نۇسخىسىدىن ئېكران سۈرىتى)
«شىمالدىكى كېچىنىڭ پادىشاھى، بىر قول كۆتۈرسە ئون مىڭ ھېسابات توڭلايدۇ» دەپ تەسۋىرلەنگەن Claude دىن تارتىپ، «ئاشلىقى تاغدەك، كائىناتنىڭ مەركىزىدە مۇقىم ئولتۇرىدىغان» Gemini غىچە؛ «ئۇچار ماشىنىسى بىلەن ETC دىن بىۋاسىتە ئۆتۈپ، راكېتاسى بىلەن ئاسمان دەرۋازىسىنى چېكىدىغان» Grok دىن تارتىپ، «شەرقىي دېڭىزغا چۆكۈپ، بېلىق ۋە راكلارنى يىغىپ، ئامبار ئېچىپ خەلققە ياردەم بېرىدىغان» DeepSeek كىچە... autoregressive دىققەت مېخانىزمىنىڭ قېلىپ ماسلاشتۇرۇشى بىلەن ئەدەبىي تەسۋىر بۇ يەردە مۇۋاپىق يۇمۇرىستىك ۋە جانلىق بىر شەكىلدە نامايان بولغان.
ئەمما مەسىلىنى «چاقچاق يېزىش»تىن «ھېساب قىلىش»قا ئۆزگەرتكەندە، قاتتىق سانلىق ھېسابلاش ۋە بەلگە لوگىكىسىغا دۇچ كېلىمىز. مەسىلەن، «4.8 TB دىن 12 TB قانداق ھېسابلىنىدۇ؟» ماقالىسىدە ھەقىقىي مىسال قىلىنغان ئالتىنچى يىللىقنىڭ ئەمەلىي مەسىلىسىدە، بۇنى ئەمەلىي سىستېمىغا كىرگۈزۈشنىڭ قىيىنچىلىقى پۈتۈنلەي باشقىچە بولىدۇ:
چوڭ تىل مودېلى ماتېماتىكىلىق ھېسابلاش قىلغاندىمۇ، ئۇنىڭ ئاستىدىكى جەريان يەنىلا كېيىنكى token نىڭ ئېھتىماللىق تەقسىماتىنى مۆلچەرلەشتىن ئىبارەت. يېتەرلىك ھېسابلاش خامچوتى بېرىپ، «چوڭقۇر تەپەككۇر (Reasoning)» ھالىتىنى ئاچقاندىمۇ، مودېل يېپىق context ئىچىدە نەچچە مىڭ خەتلىك ئىچكى مۇلاھىزە چىقىرىشى، ھەر بىر قەدەم ئاساسلىقتەك كۆرۈنۈشى مۇمكىن. لېكىن ئوتتۇرىدىكى بىر قەدەمدە ئۆلچەم بىرلىكى ياكى ساندا كىچىك پەرق كۆرۈلسە، autoregressive مېخانىزمى بۇ دەسلەپكى خاتالىقنى كېيىنكى قەدەملەرگە داۋاملىق ئېلىپ كىرىدۇ. پەقەت تىل دەرىجىسىدىكى «ئۆزىنى تەكشۈرۈش»كە تايىنىش ئۆز خاتالىقىنى ئاقلاشنىڭ تۈگىمەس دەۋرىگە چۈشۈپ قېلىشى ئاسان. قاتتىق تەلەپلىك ئىشلەپچىقىرىش مۇھىتىدىكى يېتەكلەش ياكى قۇرۇلۇش سىستېمىسىدا، ئاندا-ساندا يۈز بېرىدىغان بۇ ئېھتىماللىققا باغلىق ئويدۇرما جاۋابلارنى قوبۇل قىلغىلى بولمايدۇ.
نېمە ئۈچۈن ئوخشاش بىر ماشىنا «شاراب ئىچىپ قەھرىمانلارنى مۇھاكىمە قىلىش»نى يازغاندا سۆزگە ئۇستا، چاقچاقلارغا ئۇدۇل جاۋاب بېرەلەيدۇ، ئەمما قاتتىق بەلگە لوگىكىسى ۋە سانلىق ھېسابلاشنى بىر تەرەپ قىلغاندا سىرتقى مېخانىزمغا موھتاج بولىدۇ؟
بۇ ماقالىنىڭ ئاساسىي قارىشى:
(ئىزاھات: بۇ ماقالىدە ئويدۇرما جاۋابنى چەكلەش دېگىنىمىز، مۇستەقىل تەكشۈرۈش ۋە ئىزىنى سۈرگىلى بولىدىغان ئىجرا دەلىلى ئارقىلىق ئاساسسىز ھېسابلاشنى ئازايتىشتۇر؛ ئىجرانىڭ مۇۋەپپەقىيەتلىك بولۇشى مودېل قۇرۇش ياكى خۇلاسىنىڭ توغرىلىقىغا كاپالەت بەرمەيدۇ. ئوبيېكتىپ دەلىللەش مۇمكىن بولمىغاندا، UNVERIFIABLE دەپ بەلگە قويۇپ، ئادەم تەكشۈرۈشىنى ئەسكەرتكىلى بولىدۇ.)
1. يەككە context ئىچىدىكى ئۆز خاتالىقىنى تۈزىتىش ئالدىنقى ھېسابلاش يولىغا باغلىنىپ قېلىش، يەنى anchoring بىر تەرەپلىمىلىكىنىڭ تەسىرىگە چۈشۈپ قېلىشى مۇمكىن؛ بىرلا مودېلنى ھەم مەسىلە يېشىشكە، ھەم ھۆكۈم قىلىشقا ئىشلەتكەندە، تەپەككۇر ئۈچۈن Token نى كۆپەيتىشنىڭ ئۆزى جاۋابنىڭ توغرىلىقىنى ئىسپاتلىيالمايدۇ؛
2. سانائەت دەرىجىلىك Test-Time Compute نىڭ مۇھىم ئۇسۇلى «ھاسىل قىلىش بىلەن دەلىللەشنى ئايرىش (Dual-Agent جۈپلىكى)» ۋە «كود ئىجراسى ئارقىلىق دەلىللەش (Execution-guided Verification)» تىن ئىبارەت. دەلىللىگۈچى يېڭى context ۋە رۇخسەت قىلىنغان قوراللار تىزىملىكىنى ئىشلىتىدۇ؛ prompt ئۇنىڭدىن ئاۋۋال مۇستەقىل ھېسابلاپ، ئاندىن يېشىش ئۇسۇلىنى تەكشۈرۈشنى تەلەپ قىلىدۇ. كاندىدات جاۋاب شۇ بىر ۋاقىتتا يەنىلا كۆرۈنۈپ تۇرىدۇ؛ execution receipt ئىجرانىڭ دەلىلى بىلەن تەمىنلەيدۇ، ئەمما ماتېماتىكىلىق مودېل قۇرۇشنىڭ توغرىلىقىغا كاپالەت بەرمەيدۇ؛
3. ئادەتتىكى قۇرۇلۇش گۇرۇپپىسى مەخسۇس PRM نېرۋا مودېلىنى مەشىقلەندۈرۈشكە ئون مىليون دوللار سەرپ قىلىشىنىڭ ھاجىتى يوق. framework قەۋىتىدە (Harness-Level) ھالەت ماشىنىسى كېلىشىمى، كود sandbox ى ۋە ئوخشىمىغان يېشىش ئۇسۇللىرىنى تەكشۈرۈش ئارقىلىق، ئادەتتىكى 7B/14B يەرلىك ئوچۇق مەنبەلىك مودېللارغا تەكشۈرگىلى بولىدىغان ھېسابلاش دەلىلىنى كىرگۈزگىلى بولىدۇ. بۇلارغا بىز «يەرلىك تەپەككۇر مودېللىرىنىڭ ئاخىرقى بىر كىلومېتىرىنى تۇتاشتۇرۇش» ماقالىسىدە تىلغا ئالغان DeepSeek-R1 ۋە Qwen distilled مودېللىرى كىرىدۇ. نەتىجە يەنىلا مودېل، مودېل قۇرۇش ۋە مەسىلىنىڭ دائىرىسىگە باغلىق، خاتالىق بولماسلىقىغا كاپالەت بېرىلمەيدۇ.
30 سېكۇنتلۇق نۇسخا:
چوڭ تىل مودېلى پەقەت يېپىق context ئىچىدە «ئۆزىنى تەكشۈرۈش»كە تايانسا، خاتالىقىنى ئۆزىچە ئاقلاشنىڭ تۈگىمەس دەۋرىگە ئاسان كىرىپ قالىدۇ. بۇ ماقالە HexClaw نىڭ
engine/solve.goۋەengine/solve_verifier_node.goمەنبە كودىنى ئاساس قىلىپ، ئىنكاس چىقىرىش مەزگىلىدىكى ھېسابلاش كۈچى (TTC) نىڭ قۇرۇلۇشتىكى ئۈچ قەۋەتلىك ئەمەلىي يولىنى يېشىدۇ: سىستېما ئىجرا مەزگىلىدىكى context نى ئايرىپ (memory: off, knowledge: off)، prompt ئارقىلىق «ئاۋۋال مۇستەقىل ھېسابلاش، ئاندىن تەكشۈرۈش»نى تەلەپ قىلىپ، ماقۇللاپ كېتىشكە مايىل بىر تەرەپلىمىلىكنى قانداق ئازايتىدۇ؛ تۆت قۇرلۇق يېنىك كېلىشىم بىلەن ھەر بىر قەدەم جەريانىنى تەكشۈرۈپ، سانلىق دەلىللەش يولىدا ۋەزىپىگە باغلانغان execution receipt نى قانداق تەكشۈرىدۇ؛ receipt ئىناۋەتسىز بولسا ئىجرا يولىغا قاراپ خاتالىق قايتۇرىدۇ ياكى fallback قىلىدۇ. ئاخىرىدا ئوخشىمىغان ھەل قىلىش ئۇسۇللىرىنى ئەۋرىشكىلەپ، tolerance قائىدىسى (1e-6) ۋە ئىجرا دەلىلى ئارقىلىق، كاندىدات يېشىش ئۇسۇللىرى ماس كەلمىگەندە tie-breaker بىلەن قانداق ھۆكۈم قىلىدىغانلىقى ۋە Model-Level ئاستا تەپەككۇر بىلەن System-Level Harness نىڭ ھەمكارلىشىش ئېھتىمالى چۈشەندۈرۈلىدۇ.
تېز تەپەككۇردىن ئاستا تەپەككۇرغىچە: ئىنكاس مەزگىلىدىكى ھېسابلاش كۈچى (TTC) نىڭ تەرەققىياتى ۋە ئۆز خاتالىقىنى تۈزىتىشتىكى «قاتتىق تام»
«تېز تەپەككۇر» ۋە «ئاستا تەپەككۇر» نۇقتىسىدىن قاراپ، OpenAI نىڭ سابىق بىرلەشمە قۇرغۇچىسى، AI ئالىمى Andrej Karpathy نىڭ چوڭ تىل مودېلى خىزمەت ئۇسۇلى ھەققىدىكى تونۇشتۇرۇشىنى پايدىلانساق، مۇنداق چۈشىنىشكە بولىدۇ: autoregressive ھاسىل قىلىشنى System 1 (تېز تەپەككۇر) غا ئوخشىتىشقا بولىدۇ، ئۇ ئېھتىماللىق قېلىپلىرىنى ماسلاشتۇرۇپ كېيىنكى سۆزنى چىقىرىدۇ؛ كەسىپ ئەھمىيەت بېرىۋاتقان Test-Time Compute بولسا System 2 (ئاستا تەپەككۇر، سىناش ۋە خاتالىقتىن ئۆگىنىش، پىلانلاش ۋە سىرتقى دەلىللەش) گە يۈزلىنىدىغان بىر قۇرۇلۇش يولىدۇر.
OpenAI تەتقىقاتچىسى Noam Brown (Libratus ۋە Pluribus نى تەرەققىي قىلدۇرۇشقا يېتەكچىلىك قىلغان) TED AI 2024 دە ئويۇن قارارى ۋە ئىنكاس مەزگىلىدىكى كېڭەيتىش ھەققىدە سۆزلىگەندە بىر سېلىشتۇرۇش بەرگەن: بىر poker تەجرىبىسىدە قوشۇمچە 20 سېكۇنت ئويلىنىشتىن كەلگەن ياخشىلىنىشنى مودېل چوڭلۇقى بىلەن مەشىقلەندۈرۈش ۋاقتىنى ئايرىم-ئايرىم تەخمىنەن 100,000 ھەسسە ئاشۇرۇشنىڭ ئۈنۈمى بىلەن سېلىشتۇرغىلى بولىدۇ. بۇ شۇ تەجرىبىدىكى سېلىشتۇرۇش بولۇپ، بارلىق تىل مودېلى ۋەزىپىلىرىگە ئورتاق قوللىنىلىدىغان ئايلاندۇرۇش ئەمەس.
تېخنىكىنىڭ تەرەققىياتىغا نەزەر سالساق: ھازىر Anthropic نى باشقۇرۇۋاتقان بىرلەشمە قۇرغۇچى ۋە CEO Dario Amodei 2020-يىلى OpenAI نىڭ تەتقىقاتقا مەسئۇل مۇئاۋىن رەئىسى بولغان مەزگىلدە، گۇرۇپپىغا يېتەكچىلىك قىلىپ ئاساس سالغۇچى Scaling Laws for Neural Language Models ماقالىسىنى ئېلان قىلغان. بۇ ماقالە ئالدىن مەشىقلەندۈرۈشنىڭ كېڭەيتىش قانۇنى (Pre-training Scaling Law) نى ئوتتۇرىغا قويغان: پارامېتىر كۆلىمى، تېكىست سانلىق مەلۇماتلىرىنىڭ كۆلىمى ۋە ئالدىن مەشىقلەندۈرۈش ھېسابلاش كۈچى كۆرسەتكۈچلۈك ئاشقاندا، مودېلنىڭ ئىقتىدار loss ى تەرتىپلىك power law بويىچە تۆۋەنلەيدۇ. بۇ قانۇن دۇنيا مىقياسىدا 10,000 كارتىلىق ھېسابلاش توپىغا بولغان رىقابەتنى باشلاپ، كەسىپتە كۆپ يىللىق «كۆپ كۈچ سەرپ قىلسا مۆجىزە يارىتىلىدۇ» دېگەن قۇرۇلۇش ئېتىقادىنى شەكىللەندۈردى.
لېكىن يۇقىرى سۈپەتلىك چوڭ ھەجىملىك مەشىق ماتېرىياللىرى ئاستا-ئاستا ئازىيىپ، ئالدىن مەشىقلەندۈرۈشنىڭ قوشۇمچە پايدىسى چەككە يېقىنلاشقاندا، كەسىپنىڭ ھېسابلاش كۈچىدىكى مۇھىم نۇقتا ئىككىنچى يۆنىلىشكە يۆتكەلدى: ئىنكاس مەزگىلىدىكى كېڭەيتىش قانۇنى (Test-Time Scaling Law). OpenAI o1 مودېلنىڭ ئىنكاس جەريانىدا «ئاستا ئويلىنىشى»نىڭ يوشۇرۇن كۈچىنى كۆرسەتتى؛ DeepSeek-R1 تۈرى بولسا تېخنىكىلىق مونوپوللۇقنى بۇزۇپ، پۈتۈن كەسىپنىڭ دىققىتىنى تارتتى. بۇنىڭ ئىچىدە DeepSeek-R1-Zero نازارەتلىك ئىنچىكە تەڭشەش (SFT) cold start باسقۇچىدىن ئاتلاپ، پەقەت كۈچەيتىپ ئۆگىنىش (Pure RL) ۋە قائىدە ئاساسىدىكى مۇكاپات ئارقىلىقلا مودېلدا سىناق مەزگىلىدە تۇيۇقسىز چۈشىنىش (Aha moment)، قايتا ئويلىنىش ۋە ئۇزۇن زەنجىرلىك ھېسابلاش ئىقتىدارلىرىنىڭ ئۆزلۈكىدىن پەيدا بولىدىغانلىقىنى ئىلمىي ساھەدە تۇنجى بولۇپ تەجرىبە بىلەن كۆرسەتتى. كېيىنكى رەسمىي DeepSeek-R1 بولسا cold start سانلىق مەلۇماتلىرى بىلەن كۆپ باسقۇچلۇق مەشىقلەندۈرۈشنى بىرلەشتۈرۈپ، ئۇنى سانائەتتە ئىشلىتىشكە قاراپ ئىلگىرى سۈردى. DeepSeek گۇرۇپپىسى 2026-يىلى 9-ئاينىڭ ئوتتۇرىلىرىدا DeepSeek-V4.1-Flash نى ئېلان قىلغاندىن تارتىپ، 10-ئايدا ئىشلەپچىقىرىش دەرىجىلىك يۇقىرى ئىقتىدارلىق inference framework ى DeepInfer نى ئوچۇق مەنبە قىلغىچە (ئېلان قىلىنغاندىن بۇيان 24k GitHub Star دىن ئاشقان، رەسمىي ئامبار: github.com/deepseek-ai/DeepInfer)، ئوچۇق ۋە يېپىق مەنبە تەرەپلەرنىڭ ھەر ئىككىسى ئاساسلىق دىققىتىنى ئىنكاس مەزگىلىدىكى ھېسابلاش كۈچى (Test-Time Compute) گە يۆتكەشكە باشلىدى: مودېل جاۋاب بەرگەندە «كۆپرەك ئويلىنىش، كۆپرەك ئىزدەش، ئۆزىنى كۆپرەك تەكشۈرۈش».
ئەمما R1 غا ئوخشاش تەپەككۇر مودېللىرى قاتتىق تەلەپلىك ئىشلەپچىقىرىش ۋەزىپىسىگە كىرگۈزۈلگەندە يەنە بىر قاتتىق تام كۆرۈنىدۇ: مودېلنىڭ يېپىق context ئىچىدە ئۆزى بىلەن ئۆزى سۆزلىشىپ تەكشۈرۈشى كۆپىنچە خاتالىقنى تۈزىتىشنىڭ ئورنىغا، تېخىمۇ ئىزچىل گەپ-سۆزلەر بىلەن «ئۆزىنى ئاقلاش»قا ئايلىنىدۇ. AAAI Fellow، داڭلىق AI تەپەككۇر تەتقىقاتچىسى Subbarao Kambhampati Can Large Language Models Reason and Plan? ماقالىسىدە مۇنداق تەھلىل قىلىدۇ: autoregressive مودېللارنىڭ يېپىق تەبىئىي تىل دەۋرىدە ھەقىقىي ئۆز خاتالىقىنى تۈزىتىشى (Self-Correction) تەس؛ سىرتقى فىزىكىلىق مۇھىتتىكى دەلىللىگۈچى ئارىلاشمىغاندا، پەقەت تىل ئارقىلىق قايتا ئويلىنىش approximate retrieval نىڭ قايتا ئەۋرىشكە ئېلىشىغا ئايلىنىپ قېلىشى ئاسان. بۇ جەريانغا قاتتىق قۇرۇلۇش چەكلىمىسى قويۇلمىسا، ئاتالمىش ئىنكاس مەزگىلىدىكى ھېسابلاش كۈچى كۆپىنچە ئويدۇرما جاۋابقا بولغان ئىشەنچنى نەچچە ھەسسە كۈچەيتىدۇ.
قۇرۇلۇشنىڭ ئومۇمىي كۆرۈنۈشى: ئىنكاس مەزگىلىدىكى ھېسابلاش كۈچى (TTC) نىڭ ئۈچ قەۋەتلىك سىستېمىسى ۋە HexClaw نىڭ 5 چوڭ قۇرۇلۇش تۈۋرۈكى
HexClaw نىڭ ئوچۇق مەنبەلىك قۇرۇلۇش ئەمەلىيىتىدە، بىز ئىلىم ساھەسىنىڭ ئىنكاس مەزگىلىدىكى ھېسابلاش كۈچى ھەققىدىكى ئىلغار ئىزدىنىشلىرىنى (OpenAI o1/o3، DeepSeek-R1، Stanford s1 قاتارلىقلار) «ھاسىل قىلىش، دەلىللەش، ھۆكۈم قىلىش»تىن ئىبارەت ئۈچ قەۋەتلىك قۇرۇلۇشقا ماس كېلىدىغان 5 مۇھىم تۈۋرۈككە يىغىنچاقلىدۇق. ئاۋۋال بىر ئومۇمىي قۇرۇلۇش دىئاگراممىسى ئارقىلىق بۇ بەش تۈۋرۈكنى HexClaw نىڭ ئوچۇق مەنبەلىك ئەمەلىي ئىجراسى بىلەن بىر-بىرلەپ سېلىشتۇرىمىز:
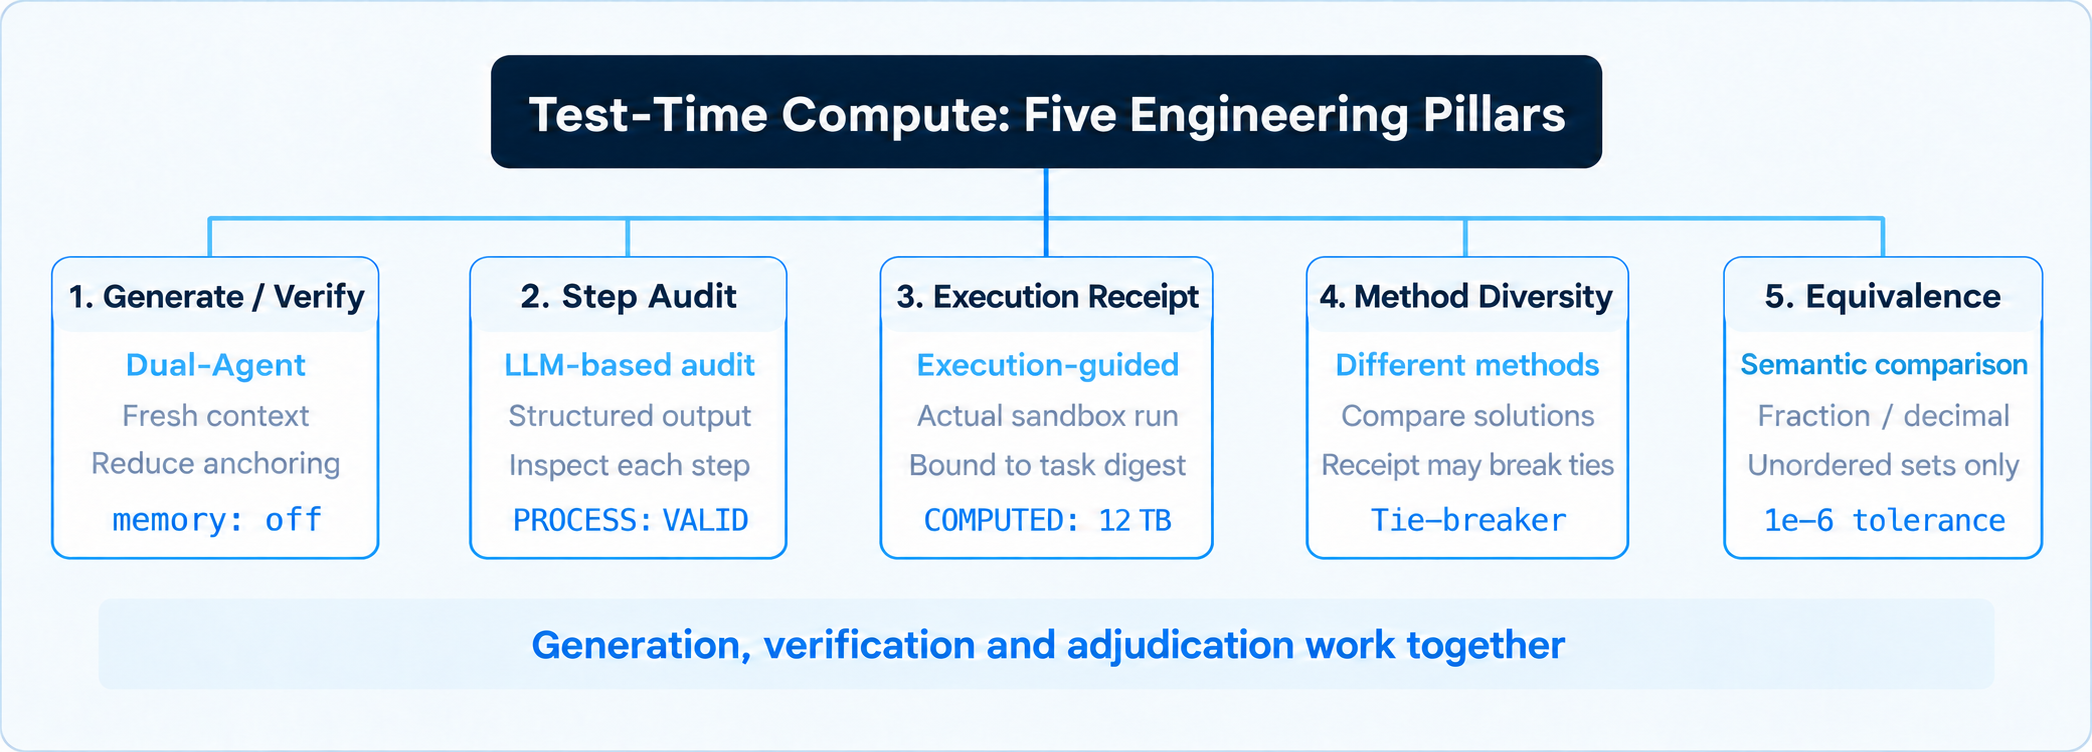
(2-رەسىم: Test-Time Compute (TTC) نىڭ 5 چوڭ ئىنژېنېرلىق تۈۋرۈكى بىلەن HexClaw ئوچۇق مەنبە كودىنىڭ ماسلىق ئومۇمىي كۆرۈنۈشى)
بۇ رەسىمدە Test-Time Compute نىڭ بەش ئىنژېنېرلىق قىسمى كۆرسىتىلىدۇ. بىرىنچىسى، Solver ھەل قىلىش ئۇسۇلىنى ھاسىل قىلىدۇ، Verifier ئۇنى ئايرىم تەكشۈرىدۇ. Verifier يېڭى context ئىشلىتىدۇ؛ ئالدىنقى سۆھبەت تارىخى، ئەستە ساقلاش ۋە بىلىم ئامبىرى ئۇنىڭغا كىرگۈزۈلمەيدۇ. لېكىن مەسىلە، نامزات جاۋاب ۋە تولۇق ھەل قىلىش ئۇسۇلى ئۇنىڭغا كۆرۈنۈپ تۇرىدۇ. ئالدى بىلەن مۇستەقىل ھېسابلاش، ئاندىن ھەل قىلىش جەريانىنى تەكشۈرۈش prompt نىڭ تەلىپى؛ بۇ فىزىكىلىق قارىغۇ تەكشۈرۈش ئەمەس. ئىككىنچىسى، LLM قەدەملەرنى قۇرۇلمىلىق شەكىلدە تەكشۈرىدۇ؛ PROCESS: VALID مۇ مودېلنىڭ ھۆكۈمى بولۇپ، جەرياننىڭ توغرىلىقىغا كاپالەت بەرمەيدۇ. ئۈچىنچىسى، مۇناسىپ يولدا كود sandbox تا مۇۋەپپەقىيەتلىك ئىجرا قىلىنغاندا، ۋەزىپىنىڭ input digest ىگە باغلانغان execution receipt ھاسىل بولۇشى مۇمكىن. Receipt ئىجرا ۋە چىقىرىش ھەققىدە دەلىل بېرىدۇ، لېكىن پروگراممىنىڭ ماتېماتىكىلىق مودېلنى توغرا قۇرغانلىقىنى ئىسپاتلىمايدۇ. تۆتىنچىسى، سىستېما ئوخشىمىغان ھەل قىلىش ئۇسۇللىرىنىڭ نەتىجىلىرىنى سېلىشتۇرىدۇ؛ ئىناۋەتلىك سانلىق ئىجرا دەلىلى بەزى ئىختىلاپلاردا tie-break قارارىغا ياردەم بېرەلەيدۇ، ئەمما ھەر قېتىم قارار چىقىرىشقا كۇپايە قىلمايدۇ. بەشىنچىسى، سېلىشتۇرۇشقا بولىدىغان سانلار ئۈچۈن 1e-6 tolerance ئىشلىتىلىدۇ؛ تەرتىپنى نەزەرگە ئالماسلىق پەقەت تەرتىپسىز ھەل توپلىمىغا ماس كېلىدۇ. ئىسىم قويۇلغان جاۋابلار ۋە تەرتىپلىك بوش ئورۇنلاردا جاۋابلارنىڭ ئۆزئارا ماسلىقى ساقلىنىدۇ.
بۇ 5 ئىنژېنېرلىق تۈۋرۈكىنى رەتلىگەندىن كېيىن شۇنى كۆرۈۋېلىشقا بولىدۇكى، پەقەت Prompt قەۋىتىدە ئۆز-ئۆزىنى تەكشۈرۈشتە مۇستەقىل ئىجرا ئىسپاتى كەم بولىدۇ؛ ھەر بىر باسقۇچ مەلۇم خەتەرنى ئازايتالايدۇ، ئەمما بارلىق خاتالىقنى يوقىتالمايدۇ.
مۇھىم پەرقلەندۈرۈش: مودېل ئىچىدىكى پىكىر يۈرگۈزۈش (Model-Level) بىلەن سىستېما دەرىجىلىك ماسلاشتۇرۇش (System-Level) نىڭ ئۆزئارا تولۇقلىشى
تېخنىكىلىق مۇزاكىرىلەردە نۇرغۇن ئىنژېنېرلار مۇنداق سوئال سورايدۇ: «OpenAI o1 ۋە DeepSeek-R1 مودېل ئىچىدە long thinking نى قوللايدىغان تۇرسا، قوللىنىش قەۋىتى نېمىشقا سىرتتا ئىككى Agent ۋە كود sandbox ئارقىلىق ھېسابلاشنى يەنە تەكشۈرىدۇ؟»
بۇ سوئالنىڭ ئارقىسىدا مۇھىم بىر تېخنىكىلىق ئورۇن بېكىتىش بار: Model-Level نىڭ ئاستا پىكىر يۈرگۈزۈشى بىلەن System-Level سىرتقى Harness نىڭ ئۆزئارا تولۇقلىشى.
| سېلىشتۇرۇش ئۆلچىمى | OpenAI o1 / DeepSeek-R1 | HexClaw نىڭ solve.go ئوچۇق مەنبەلىك قۇرۇلمىسى |
|---|---|---|
| ئەمەلگە ئاشۇرۇش قەۋىتى | Model-Level (مودېل ئېغىرلىقلىرى ئىچىدە) مودېل ئېغىرلىقلىرى ئىچىدە كەڭ كۆلەملىك كۈچەيتىپ ئۆگىنىش (RL) ئارقىلىق ئۇزۇن تەپەككۇر زەنجىرى (<think> tokens) مەشىق قىلىنىدۇ |
System / Harness-Level (سىستېما رامكا قەۋىتى) سىرتقى Harness ئارقىلىق Solver + Verifier ئىككى Agent ۋە كود ئىجرا sandbox ى ماسلاشتۇرۇلىدۇ |
| ئىشلەش ئۇسۇلى | بىر مودېل ۋە بىر context ئىچىدىكى «ئىچكى سۆھبەت»؛ autoregressive ئېھتىماللىقىغا تايىنىپ پىكىرنى قەدەممۇ قەدەم ھاسىل قىلىدۇ | مۇستەقىل context ۋە قوراللارنىڭ رۇخسەت تىزىملىكى؛ prompt ئاۋۋال مۇستەقىل قايتا ھېسابلاشنى، ئاندىن ھەر بىر قەدەمنى تەكشۈرۈشنى تەلەپ قىلىدۇ، نامزات جاۋاب يوشۇرۇلمايدۇ |
| دەلىللەش ئۇسۇلى | مودېل ئىچىدىكى autoregressive ئۇزۇن تەپەككۇر زەنجىرى (پەقەت تىل ئارقىلىق يەكۈن چىقىرىدۇ، سۈكۈتتىكى ئەھۋالدا سىرتقى ئەمەلىي sandbox نىڭ ئىجرا receipt ى يوق) | سىرتقى كود sandbox ى (code_exec) ۋەزىپە كىرگۈزۈش digest ىغا باغلانغان execution receipt بىلەن تەمىنلىيەلەيدۇ؛ كونكرېت ھەرىكەت دەلىللەش يولىغا قاراپ پەرقلىنىدۇ |
| ھېسابلاش مەنبەسىگە قويۇلىدىغان تەلەپ | مودېل قۇرۇلمىسى ۋە مەشىق ئۇسۇلىغا باغلىق؛ پىكىر يۈرگۈزۈش مودېلىنى مەشىق قىلىش زور مىقداردا سانلىق مەلۇمات ۋە ھېسابلاش مەنبەسى تەلەپ قىلىشى مۇمكىن | 7B/14B يەرلىك ئوچۇق مەنبەلىك مودېللارنى قايتا ئىشلىتىشكە بولىدۇ، بىراق مودېل ۋە sandbox مەنبەسى يەنىلا زۆرۈر؛ بۇ نەتىجىنىڭ توغرىلىقىغا كاپالەت بەرمەيدۇ |
| ئىسپات ۋە چەك | ئۇزۇن ئۆز-ئۆزىنى تەكشۈرۈشتىن كېيىنمۇ ئىپادىسى تېخىمۇ ئىشەندۈرگۈدەك «يۇقىرى ئىشەنچلىك hallucination» پەيدا بولۇشى مۇمكىن | ئىككى خىل ئىسپات: receipt ئىجرا ئەھۋالىنى خاتىرىلەيدۇ، جەرياننى تەكشۈرۈشكە مودېل مەسئۇل؛ receipt مەغلۇپ بولغاندا ھەرىكەت يول ۋە خاتالىققا قاراپ پەرقلىنىدۇ |
| ئىككىسىنىڭ مۇناسىۋىتى | مودېل ئىچىدىكى پىكىر يۈرگۈزۈش ۋە پەرەز ھاسىل قىلىشقا مەركەزلىشىدۇ (Generator ئاساسى) | ھەمكارلىشالايدۇ، ئۈنۈمىنى باھالاش كېرەك: مودېل ئىچىدىكى ئۇزۇن تەپەككۇر زەنجىرى × سىستېما سىرتىدىكى ئەمەلىي sandbox نىڭ execution receipt ى |
بىز ئىلگىرىكى «Loop Engineering» ماقالىسىدە تۆت ئەۋلاد پارادېگمىنىڭ تەرەققىياتىنى تەھلىل قىلغاندا، كونترول قەۋىتىنى سىرتقا چىقىرىشنى مۇھىم نۇقتا قىلغان ئىدۇق؛ Anthropic بولسا 2024-يىلىنىڭ ئاخىرىدا ئېلان قىلغان «Building Effective Agents» ماقالىسىدە بۇ خىل قۇرۇلمىنى كلاسسىك Evaluator-Optimizer (باھالىغۇچى-ياخشىلىغۇچى) پارادېگمىسى دەپ بايان قىلغان:
Anthropic Evaluator-Optimizer نى بىرى ھاسىل قىلىپ، يەنە بىرى باھالاپ ئىنكاس قايتۇرىدىغان تەكرارلىنىش ئۇسۇلى دەپ تەسۋىرلەيدۇ؛ ئۇ باھالاش ئۆلچىمى ئېنىق ۋە تەكرارلاشنىڭ قىممىتىنى ئۆلچىگىلى بولىدىغان ۋەزىپىلەرگە ماس كېلىدۇ. Agent ھەققىدىكى بۆلۈمدە قورال نەتىجىسىگە ئوخشاش مۇھىت ئىنكاسلىرىدىن پايدىلىنىشمۇ تەكىتلىنىدۇ. بۇ ماقالە مۇشۇ پىكىر ئاساسىدا execution receipt نى مۇلاھىزە قىلىدۇ: receipt ئىجرا ئىسپاتى بىلەن تەمىنلەيدۇ، ئەمما مودېل قۇرۇلۇشىنى ۋە مەسىلىنىڭ ئالدىنقى شەرتلىرىنى تەكشۈرۈشنىڭ ئورنىنى ئالالمايدۇ.
—— ئاساسىي ئىدىيە مەنبەسى: Anthropic Engineering, Building Effective Agents (2024-12)
بۇ يەرگە كەلگەندە نۇرغۇن قۇرۇلما لايىھەلىگۈچىلەر مۇنداق سوئال سورايدۇ: «ئەگەر ئاستى قەۋەتتىكى پىكىر يۈرگۈزۈشنى تېزلىتىش ئۈچۈن DeepInfer غا ئالماشتۇرغان بولسام، ياكى ئاساسىي مودېل سۈپىتىدە long thinking بار DeepSeek-R1 / o1 نى تاللىغان بولسام، قوللىنىش قەۋىتى نېمىشقا بۇ سىرتقى ئىككى Agent ۋە sandbox سىستېمىسىغا يەنىلا موھتاج؟»
جاۋاب شۇكى، بۇ ئىككى قەۋەت ھەمكارلىشالايدۇ، ئەمەلىي پايدىسىنى يەنىلا باھالاش كېرەك. DeepInfer قاتارلىق رامكىلار ئۇل ئەسلىھە قەۋىتىدە پىكىر يۈرگۈزۈش ھېسابلاش مەنبەسىنىڭ يۇقىرى ئۆتكۈزۈشچانلىق بىلەن تەقسىملىنىشى ۋە ئاخىرىدىن ئاخىرىغىچە كېچىكىش مەسىلىسىنى بىر تەرەپ قىلىدۇ؛ R1/o1 ئېغىرلىق قەۋىتىدە ئىچكى تەپەككۇر زەنجىرى (<think> tokens) نىڭ ئىزدىنىش دائىرىسىنى بىر تەرەپ قىلىدۇ؛ HexClaw بولسا سىستېما قەۋىتىدە پىكىرنى تەكشۈرگىلى بولىدىغان deterministic ئىجرا ئىسپاتىغا باغلايدىغان execution receipt بىلەن تەمىنلەيدۇ. ئاستىدىكى مودېلنىڭ ئاستا پىكىر يۈرگۈزۈش ئىقتىدارى ئىنتايىن كۈچلۈك بولغان تەقدىردىمۇ، يېپىق autoregressive تەبىئىي تىل دەۋرىدە ئۇ ئۆزىنىڭ تۆت خىل ھېسابلاش ئەمەلى ئۈچۈن ئوبيېكتىپ پروگرامما ئىجرا ئىسپاتىنى ئۆزى بېرەلمەيدۇ؛ مودېل ئىچىدىكى پىكىر يۈرگۈزۈش بىلەن سىرتقى sandbox نى بىرلەشتۈرۈش ئىجرا جەريانىنى تېخىمۇ ئىز قوغلىغىلى بولىدىغان قىلىدۇ، ئەمما مودېل قۇرۇش ياكى جەرياننى تەكشۈرۈشتە يەنىلا خاتالىق بولۇشى مۇمكىن، ئۈنۈمنى ئەمەلىي ۋەزىپە بويىچە باھالاش كېرەك.
تۆۋەندە HexClaw ئوچۇق مەنبە كودىنى كۆرۈپ، بۇ 5 چوڭ تۈۋرۈكنىڭ ئىنژېنېرلىقتىكى ئەمەلىي ئىجراسىنى بىر-بىرلەپ تەھلىل قىلىمىز.
بىرىنچى تۈۋرۈك · ھەل قىلىش بىلەن دەلىللەشنى ئايرىش (Dual-Agent): autoregressive جەرياندىكى «ماقۇللاپ كېتىش ۋە دەسلەپكى تەسىرگە باغلىنىش»تىن ساقلىنىش
ئالدىنقى «Harness Engineering» ماقالىسىدە ئادەتتىكى تەسەۋۋۇرغا زىت بىر تەركىب — تەكشۈرگۈچىلەر ئائىلىسى ھەققىدە سۆزلەشكەن ئىدۇق. پۇل مۇئامىلە سىستېمىسىدا بۇ maker/checker دەپ ئاتىلىدۇ: ئىشنى قىلغۇچى بىلەن قايتا تەكشۈرگۈچى ئايرىم ئىككى كىشى بولۇشى كېرەك. تۈگمەندە ئىشلەۋاتقان «سىبېر ئەمگەكچى» ئۆزىگە ئۆزى سۈپەت تەكشۈرۈش گۇۋاھنامىسى بەرمەسلىكى كېرەك.
HexClaw نىڭ پىكىر يۈرگۈزۈش ماتورىنىڭ ئاساسىي پىلانلىغۇچىسى engine/solve.go دا، مەسىلە ھەل قىلىش جەريانى تۇراقلىقلار ئېنىقلانغان باسقۇچتىن باشلاپلا ۋەزىپىسى ئوخشىمايدىغان تارماق Agent لارغا ئايرىلىدۇ:
كۆپ ئۇچرايدىغان ئىككى باسقۇچلۇق تەكشۈرۈشتە ھەل قىلغۇچىنىڭ تولۇق سۆھبىتى ئاخىرىغا ئۇلىنىپ، پەقەت «يۇقىرىدىكى جاۋابنىڭ توغرىلىقىنى تەكشۈرۈڭ» دېگەن بىر جۈملە قوشۇلىدۇ. بۇ خىل كىرگۈزۈش شەكلىدە self-attention ئالدىنقى تېكىستنىڭ ئېھتىماللىق تەقسىماتىغا ئەگىشىپ كېڭىيىدۇ؛ Verifier ئالدىنقى تەپەككۇر زەنجىرى كەلتۈرگەن Anchoring Bias نىڭ تەسىرىگە ئاسان ئۇچراپ، ئىلگىرىكى يەكۈننى تەستىقلاپ، «لوگىكىسى پۇختا، پۈتۈنلەي توغرا» دېگەن قوشۇلۇش خۇلاسىسىگە مايىل بولىدۇ.
HexClaw Verifier ئۈچۈن ئىجرا ۋاقتىدا ھالەتسىز ئايرىش نى ئىشلىتىدۇ:
بۇ يەردىكى metadata تەكشۈرۈشى ئاساسىي سۆھبەتنىڭ بارلىق تارىخىنى، ئۇزاق مۇددەتلىك ئەستە ساقلاشنى (memory: off؛ «چۈش كۆرىدىغان Agent ئەستە ساقلىشى» دا توپلانغان ئۇزاق مۇددەتلىك ئارخىپنى توسۇپ تۇرىدۇ) ۋە سىرتقى بىلىم ئامبىرىنى (knowledge: off؛ «Context Engineering» دا تەپسىلىي بايان قىلىنغان ئىزدەپ كۈچەيتىش يولىنى ئۈزۈپ تۇرىدۇ) چەتكە چىقىرىدۇ. بۇ ئايرىش ئىجرا ۋاقتىدىكى يېڭى context بىلەن ئايرىش (Fresh Context Isolation) بولۇپ، ئاساسىي سۆھبەتتىن يىغىلىپ قالغان دىققەت قالايمىقانچىلىقى ۋە كېرەكسىز قوراللارنى چىقىرىۋېتىدۇ؛ Verifier ئەسلى مەسىلىنى، تەكشۈرۈلىدىغان تولۇق ھەل قىلىش ئۇسۇلىنى ۋە نامزات جاۋابنى ئالىدۇ، ھەل قىلىش مەزمۇنى يوشۇرۇلمايدۇ.
ماسلاشتۇرۇش كېلىشىمىنىڭ prompt قەۋىتىدە سىستېما «ئاۋۋال مۇستەقىل قايتا ھېسابلاش، ئاندىن ھەل قىلىش ئۇسۇلىنى تەكشۈرۈش» تەرتىپىنى تەلەپ قىلىپ، ئالدىنقى جاۋابقا ماقۇللاپ كېتىشنى ئازايتىشنى كۆزلەيدۇ:
«سانلىق ھېسابلاش مەسىلىلىرىدە، ئاۋۋال code_exec ئارقىلىق پۈتۈنلەي مۇستەقىل كود يېزىپ توغرا جاۋابنى قايتا ھېسابلاڭ، تەكشۈرۈلىدىغان مەزمۇنغا ئالدى بىلەن ئىشەنمەڭ؛ مۇستەقىل ھېسابلىغاندىن كېيىن، تەمىنلەنگەن تولۇق ھەل قىلىش ئۇسۇلىنى قەدەممۇ قەدەم تەكشۈرۈڭ.»——hexclaw/engine/solve.go:1230Prompt چەكلىمە قېلىپىدىن ئۈزۈندە
بۇ يەردىكى چەكنى ئېنىق كۆرۈش كېرەك: ھازىرقى ئىجرا ئۇسۇلىدا سوئال بىلەن نامزات ھەل قىلىش ئۇسۇلى prompt قا بىرلا قېتىمدا كىرگۈزۈلىدۇ. «ئالدى بىلەن ھېسابلاش، ئاندىن تەكشۈرۈش» دېگىنى prompt قاتلىمىدىكى ۋاقىت تەرتىپى كېلىشىمى (In-Context Temporal Protocol) بولۇپ، كۈچلۈك كۆرسەتمە ئارقىلىق مودېلنى ئالدى بىلەن مۇستەقىل ھالدا تەڭلىمە تۈزۈپ مودېللاشتۇرۇشقا يېتەكلەيدۇ؛ بۇ نامزات جاۋاب كەلتۈرۈپ چىقارغان ئالدىنقى قاراش ۋە anchoring bias نى ئىمكانقەدەر ئازايتىدۇ. بۇ، جاۋابنى تور ئۇلىنىشىدا ئىككى ئايلانمىغا بۆلۈپ يوشۇرىدىغان فىزىكىلىق blind review ئەمەس.
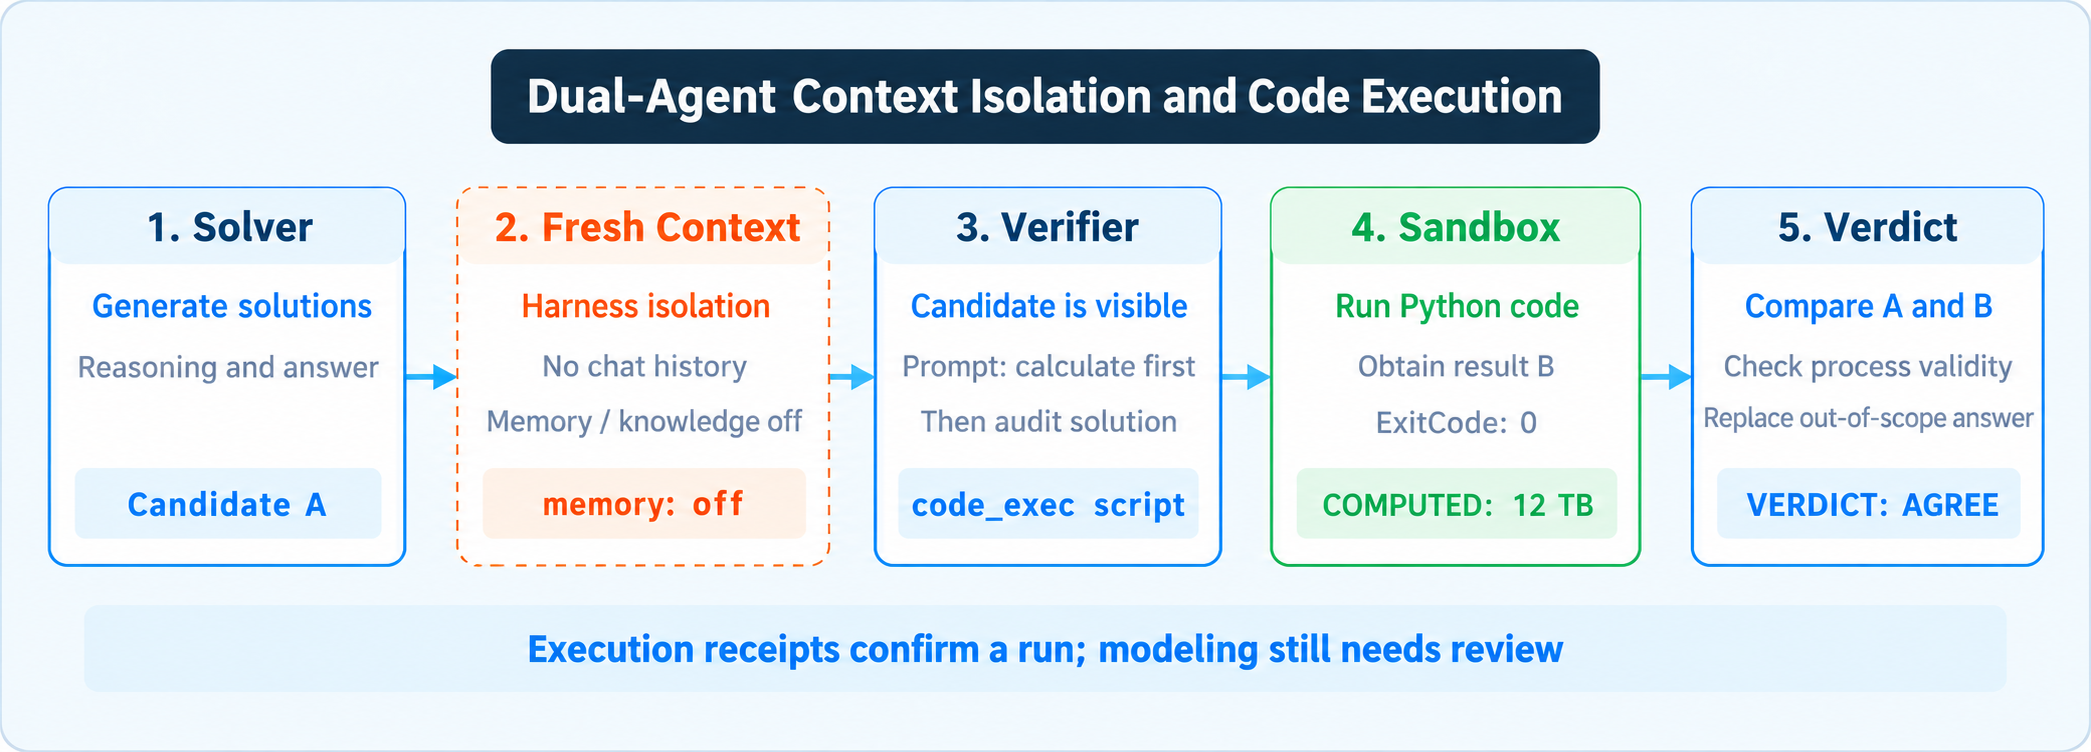
(3-رەسىم: Dual-Agent ئارىسىدىكى ئايرىۋېتىلگەن ئۆزئارا تەسىر ۋە كودنى ئەمەلىي ئىجرا قىلىشنىڭ تولۇق ۋاقىت تەرتىپى. چىقىش كودىنىڭ 0 بولۇشى receipt نى تەكشۈرۈش شەرتلىرىنىڭ بىرىلا؛ ۋەزىپە بىلەن باغلىنىشى ۋە چىقىرىشنىڭ تولۇقلۇقىمۇ تەكشۈرۈلىدۇ. ئىجرا مۇۋەپپەقىيىتى مودېللاشتۇرۇشنىڭ توغرىلىقىنى ئىسپاتلىمايدۇ.)
بۇ رەسىمدىكى تەرتىپ مۇنداق: Solver مەسىلىنى ھەل قىلىپ، پىكىر يۈرگۈزۈش جەريانى ۋە نامزات A نى بېرىدۇ. Verifier ئالدىنقى سۆھبەت تارىخى، ئەستە ساقلاش ۋە بىلىم ئامبىرى كىرگۈزۈلمىگەن يېڭى context تا ئىشلەيدۇ؛ شۇنىڭ بىلەن بىللە، ئۇ مەسىلىنى، نامزات جاۋابنى ۋە تولۇق ھەل قىلىش ئۇسۇلىنى كۆرەلەيدۇ. Prompt ئۇنىڭدىن ئالدى بىلەن مۇستەقىل ھېسابلاشنى، ئاندىن ھەل قىلىش جەريانىنى تەكشۈرۈشنى تەلەپ قىلىدۇ. مۇناسىپ يولدا Sandbox Python كودىنى مۇۋەپپەقىيەتلىك ئىجرا قىلغاندا، B نەتىجىسى ۋە ۋەزىپىگە باغلانغان execution receipt ھاسىل بولۇشى مۇمكىن؛ رەسىمدىكى ExitCode: 0 ۋە COMPUTED: 12 TB پەقەت بىر مىسال. ExitCode: 0 يالغۇز ئۆزى تولۇق ۋە ئىناۋەتلىك receipt ئۈچۈن يېتەرلىك ئەمەس: ۋەزىپىگە باغلىنىش ۋە چىقىرىشنىڭ تولۇقلۇقىمۇ تەكشۈرۈلىدۇ. Receipt پروگراممىنىڭ ئىجراسى ۋە چىقىرىشىنى كۆرسىتىدۇ، ماتېماتىكىلىق مودېلنىڭ توغرىلىقىنى كاپالەتلەندۈرمەيدۇ. سىستېما A بىلەن B نى سېلىشتۇرۇپ، جەريان تەكشۈرۈشىنىمۇ نەزەرگە ئېلىپ قارار بېرىدۇ؛ VERDICT: AGREE رەسىمدىكى مىسال. OUT_OF_SCOPE بولغان ھەل دائىرە ئىچىدە قايتا ھەل قىلىنغاندىن كېيىنلا تۈزىتىپ ئالماشتۇرۇش قارىلىدۇ؛ ئادەتتىكى ئىختىلاپنىڭ ئۆزى ئاپتوماتىك ئالماشتۇرۇش دېگەنلىك ئەمەس. ئىناۋەتلىك receipt بولمىغاندا مۇستەقىل قۇرۇلمىلىق verifier خاتالىق قايتۇرىدۇ؛ ئادەتتىكى يولدا بولسا ئەھۋالغا قاراپ ئاجىزراق model-only دەلىلگە چۈشۈش ياكى خاتالىق قايتۇرۇش مۇمكىن.
2-تۈۋرۈك · قەدەم دەرىجىسىدىكى جەريان تەكشۈرۈش كېلىشىمى: يېنىك دەرىجىلىك PRM نىڭ قۇرۇلۇشتىكى ئەمەلىيلىشىشى
ئەگەر تەكشۈرۈشتە پەقەت ئاخىرقى جاۋابقا قارالسا، سىستېما ناھايىتى يوشۇرۇن بىر مەسىلىنى ئۆتكۈزۈۋېتىدۇ: خاتا ئۇسۇل بىلەن تاسادىپىي توغرا جاۋابقا ئېرىشىش. ھېسابلاش جەريانىدا پارامېتىرلار مۇناسىۋىتى پۈتۈنلەي تەتۈر چۈشىنىلىپ، ئىككى ھېساب خاتالىقى تاسادىپىي بىر-بىرىنى بىكار قىلىپ، ئاخىرى توغرا سان چىقىپ قېلىشى مۇمكىن.
بۇ دەل ORM (Outcome Reward Model، نەتىجىنى مۇكاپاتلاش مودېلى) نىڭ ئەسلىدىكى كۆرەلمەيدىغان يېرى: پەقەت ئاخىرقى ھالەتكە ئاساسەن نومۇر قويغاندا، ئارىلىقتىكى قەدەملەرنىڭ لوگىكىلىق خاتالىقىنى ئۆتكۈزۈۋېتىش ئاسان. OpenAI 2023-يىلى ئېلان قىلغان «Let's Verify Step by Step» ماقالىسىدە PRM (Process Reward Model، جەرياننى مۇكاپاتلاش مودېلى) نى ئوتتۇرىغا قويۇپ، ھەر بىر ئارىلىق قەدەمنى ئايرىم باھالاشنى ئىلگىرى سۈردى. بۇ نەزەرىيەدە قاتتىق بولسىمۇ، مەلۇم سودا ساھەسى ئۈچۈن ئون مىڭلىغان قەدەم سانلىق مەلۇماتىنى ئايرىم بەلگىلەپ، مەخسۇس PRM باھالاش مودېلىنى باشتىن مەشىقلەندۈرۈشنىڭ GPU ئىچكى ساقلىغۇچى ۋە قۇرۇلۇش چىقىمى ئىنتايىن يۇقىرى.
بۇنى ئېنىق ئايرىش كېرەك: HexClaw بۇ يەردە مەخسۇس جەريان مۇكاپاتلاش نېرۋا تورىنى مەشىقلەندۈرۈش ئۈچۈن نەچچە ئون مىليون دوللار خەجلىمىگەن. «Prompt Engineering» دا مۇزاكىرە قىلىنغاندەك، Prompt Agent نىڭ ئەڭ ئاستىدىكى ئۆزئارا تەسىر كېلىشىمى سۈپىتىدە ئىشلىتىلىدۇ؛ framework قاتلىمىدا (Harness-Level) LLM-as-Judge قاتتىق تۆت قۇرلۇق كېلىشىم بىلەن بىرلەشتۈرۈلۈپ، مودېل ھۆكۈمىگە ئاساسەن قەدەم دەرىجىسىدە جەرياننى رەت قىلىش ئەمەلگە ئاشۇرۇلىدۇ. بۇ كېلىشىم ئارقىلىق تەكشۈرۈشتۇر؛ مەشىقلەندۈرۈلگەن PRM بىلەن ئوخشاش ئەمەس، تەكشۈرۈشنىڭ توغرىلىقىنىمۇ كاپالەتكە ئىگە قىلمايدۇ. تۆۋەندىكى مىسالدا مەكتەپ باسقۇچى چەكلىمىسى تەمىنلەنگەندىكى فورمات كۆرسىتىلگەن؛ چەكلىمە تەمىنلەنمىسە OUT_OF_SCOPE بولمايدۇ:
يادرولۇق ھۆكۈم چىقىرىش ئېقىمى verifySolutionWithGuides (solve.go:874-876) دا سىستېما جەرياننىڭ ئىناۋەتلىك بولۇشىنى مەجبۇرىي شەرت قىلىدۇ:
PROCESS: INVALID پارسلانغاندىن كېيىن، سوئال دەرس دائىرىسىدىن ھالقىمىغان بولسىلا، سىستېما verdict نى شەرتسىز DISAGREE غا ئۆزگەرتىدۇ. ئۇنىڭدىن كېيىنكى formatSolve (solve.go:1570؛ ئاگاھلاندۇرۇشنى كۆرسىتىش ئۈچۈن line 1614 گە قاراڭ) پەقەت تەكشۈرۈشتىن ئۆتمىگەندە ئىشلەتكۈچىگە ئاگاھلاندۇرۇش قۇرىنى كۆرسىتىشكە مەسئۇل، ھۆكۈمنىڭ ئۆزىگە قاتناشمايدۇ. شۇنىڭ بىلەن بىرگە، ئىلغار تەكشۈرۈش يولىدا سىستېما solve_verifier_node.go ئارقىلىق قۇرۇلمىلىق verificationStep JSON كېلىشىمىنى ئالدىن تەييارلاپ، مەلۇم سىنىپنىڭ ئوقۇتۇش پروگراممىسىنى چوڭقۇر تەكشۈرۈش ئۈچۈن ئۆلچەملىك سانلىق مەلۇمات فورماتى بىلەن تەمىنلەيدۇ.
ھەل قىلغۇچىنىڭ ئاخىرقى جاۋابى بىلەن دەلىللىگۈچى ھېسابلىغان سان ئوخشاش بولغان تەقدىردىمۇ، مۇھىم بىر قەدەم ئىناۋەتسىز دەپ بەلگىلەنسە، سىستېما يەنىلا ئۇنى دەلىللەشتىن ئۆتمىدى دەپ قاراپ، ئېنىق ئاگاھلاندۇرۇش چىقىرىدۇ. جاۋاب تاسادىپىي توغرا چىقىپ، جەريان خاتا بولسا، چوقۇم DISAGREE دەپ ھۆكۈم قىلىنىدۇ. قۇرۇلۇش ئەمەلىيىتىدە جەريان خاتا دەپ قارالغان نەتىجە تاسادىپىي توغرا چىققان تەقدىردىمۇ ئۆتكۈزۈلمەسلىكى كېرەك؛ بۇ يالغان ئىشەنچ پەيدا بولۇشىدىن ساقلايدۇ.
3-تۈۋرۈك · كود ئىجراسىنىڭ execution receipt ى (Execution-Guided): قوش يوللۇق ئارىلاش ھۆكۈم ۋە ۋەزىپە digest ى بىلەن باغلاش
تەبىئىي تىل ئارقىلىق تەبىئىي تىلنى تەكشۈرۈش دېگىنى، ئەمەلىيەتتە گاللىيۇتسىناتسىيە پەيدا قىلىشى مۇمكىن بولغان ئېھتىماللىققا ئاساسلانغان بىر تېكىست بىلەن يەنە بىر شۇنداق تېكىستنى باھالاش دېمەكتۇر؛ ئىككى تەرەپمۇ ئېھتىماللىققا تايىنىپ پەرەز قىلىدۇ، شۇڭا سىستېما ھۆكۈم چىقىرىشنى تولۇق تاقىۋېتەلمەيدۇ. Program-Aided Language Models (PAL, Gao et al., 2022) بېكىتكەن ۋەزىپە تەقسىماتى بويىچە، چوڭ تىل مودېلى بەلگىلەرنى چۈشىنىش ۋە پروگرامما يېزىشقا مەسئۇل بولىدۇ، كونكرېت سانلىق ھېسابلاش بولسا ئۇنىڭدىن ئايرىلىپ، سىرتقى deterministic interpreter غا تاپشۇرۇلىدۇ.
بىراق بۇ يەردە ئارىلاشتۇرۇۋېتىشكە بولمايدىغان قۇرۇلۇش چېگراسى بار: interpreter نىڭ مۇۋەپپەقىيەتلىك ئىجرا بولۇشى ماتېماتىكىلىق مودېللاشتۇرۇشنىڭ توغرا بولغانلىقىدىن دېرەك بەرمەيدۇ.
ئېنىق بىر قارشى مىسالغا قارايلى: باشتىكى ساقلاش مەسىلىسىدە ئىشلىتىلگەن بوشلۇق 4.8 TB بولۇپ، ئومۇمىي سىغىمنىڭ 2/5 قىسمىنى ئىگىلەيدۇ؛ توغرا ئومۇمىي سىغىم 12 TB بولۇشى كېرەك. ئەگەر چوڭ مودېل Python يازغاندا خاتالىشىپ بۆلۈشنى كۆپەيتىش دەپ مودېللاشتۇرسە:
چىقىش كودى 0 بولۇشى پەقەت Python interpreter نىڭ script نى ئەينەن ئىجرا قىلىپ تاماملىغانلىقىنى ئىسپاتلايدۇ؛ ئۇ «قىسمەن مىقدارنى ئۇنىڭ نىسبىتىگە بۆلۈش» دېگەن مودېل مۇناسىۋىتىنى تەكشۈرۈپ بېرەلمەيدۇ. شۇڭا ئىشەنچلىك دەلىللەش زەنجىرى بىر-بىرىدىن مۇستەقىل ئۈچ سوئالغا جاۋاب بېرىشى كېرەك: پروگرامما مۇۋەپپەقىيەتلىك ئىجرا بولدىمۇ (ئىجرا دەلىلى)، ھېسابلاش نەتىجىسىنى سېلىشتۇرغىلى بولامدۇ (تەڭ قىممەتلىككە ھۆكۈم قىلىش)، مەسىلە ھەل قىلىش جەريانى توغرىمۇ (قەدەم تەكشۈرۈشى). بۇ ئۈچ نەرسىنى ئارىلاشتۇرۇپ، پەقەت مۈجمەل «دەلىللەندى» دېگەن بەلگىگە قارىساق، يوشۇرۇن مەسىلە كۆرۈنمەي قالىدۇ.
HexClaw دەلىللىگۈچىسىنىڭ لايىھەسىدە، سىستېما دەلىللىگۈچىگە پەقەت بىر deterministic قورال — code_exec نى بېرىدۇ. ئەمەلىي receipt تەكشۈرۈشى يادرولۇق ماسلاشتۇرۇش ئېقىمى verifySolutionWithGuides (solve.go:845-856) دا يۈز بېرىدۇ؛ سىستېما computedOutput(attempt.Task) ئارقىلىق ئىجرا مۇۋەپپەقىيىتىنى تەكشۈرىدۇ:
بۇ يەردىكى چەكلىمىلەر كود ئارقىلىق قاتتىق ئىجرا قىلىنىدۇ: ۋاقىتتىن ئېشىش (Timeout)، ئىچكى ساقلىغۇچ خاتالىقى، تۈگىمەس دەۋرىيلىك، standard output نىڭ كېسىلىشى ياكى نۆل بولمىغان چىقىش كودىنىڭ ھەرقاندىقى رەت قىلىشقا يېتىدۇ. executionInputDigest(task) ئارقىلىق كىرگۈزۈلگەن ۋەزىپىنىڭ SHA256 digest ى ھېسابلىنىپ، receipt ۋەزىپىگە ئېنىق باغلىنىدۇ؛ بۇ receipt نىڭ باشقا ۋەزىپىگە خاتا ماسلاشتۇرۇلۇشى ياكى يۆتكىلىپ ئىشلىتىلىشىنىڭ ئالدىنى ئالىدۇ.
چىقىرىشنى پارسلاشتا سىستېما «ئالدى بىلەن بەلگە قۇرىنى ئوقۇش، بولمىسا يەككە قۇرغا fallback قىلىش» ئىستراتېگىيەسىنى قوللىنىدۇ: ئالدى بىلەن (?im)^COMPUTED:[ \t]*([^\r\n]+) regular expression غا ماس كېلىدىغان بەلگە قۇرى ئېلىنىدۇ. پەقەت بىر قۇر نەتىجە چىقىرىدىغان ئاددىي script لارغا ماسلىشىش ئۈچۈن، بەلگە بولمىسا ۋە standard output بوش بولمىغان بىر قۇردىن تەركىب تاپسا، شۇ قۇر ئېلىنىدۇ. قۇرنى ئېلىشنىڭ مۇۋەپپەقىيەتلىك بولۇشى ئۆزلىكىدىن سانلىق دەلىلگە ئېرىشىلگەنلىكىدىن دېرەك بەرمەيدۇ؛ كېيىن جاۋابنى يەنە تەكشۈرۈش كېرەك. ئاپتوماتلاشتۇرۇلغان كېلىشىم سىنىقى engine/solve_storage_quantity_test.go:72 دا، سىناق قىسمى receipt نى تونۇش ۋە solve_evidence=numeric_exec metadata باغلىنىش زەنجىرىنى دەلىللەيدۇ.
ئەمەلىي ئىشلەپچىقىرىش يولىدا سىستېما يەنە مودېلنىڭ ناھايىتى يوشۇرۇن بىر خاتالىقىنى توسۇپ قالىدۇ: syntax ئوڭشاش جەريانىدا تەكشۈرۈش نەتىجىسىنىڭ قوشۇپ ئۆزگەرتىلىشى (Syntax Repair Audit Tampering). دەلىللىگۈچى يازغان Python script ى بەزىدە فورماتتىكى كىچىك خاتالىق سەۋەبىدىن (مەسىلەن، indentation دا بىر بوشلۇق ئارتۇق بولۇپ، IndentationError كۆرۈلسە) sandbox دا خاتالىق كەلتۈرۈپ چىقىرىشى مۇمكىن. پۈتۈن ۋەزىپىنى ئوڭايسىزلا قايتا ھېسابلاشقا يوللىغاندا، مودېل بوشلۇقنى تۈزىتىش بىلەن بىر ۋاقىتتا، بىرىنچى ئايلانمىدا «جەريان ئىناۋەتسىز (INVALID)» دەپ ھۆكۈم قىلىنغان تەكشۈرۈش نەتىجىسىنى «ئىناۋەتلىك (VALID)» دەپ ئۆزگەرتىۋېتىشى مۇمكىن! HexClaw نىڭ قۇرۇلمىلىق دەلىللەش تۈگۈنى (solve_verifier_node.go) دا، سىستېما قاتتىق چەكلەنگەن بىر قېتىملىق syntax ئەسلىگە كەلتۈرۈشنى لايىھەلەپ، بىرىنچى ئايلانمىدىكى تەكشۈرۈش ھۆكۈمىنى كود ئارقىلىق مۇقىم ساقلايدۇ:
ئىككىنچى قېتىم قايتا يېزىلغان كود مۇۋەپپەقىيەتلىك ئىجرا بولغان تەقدىردىمۇ، ئەسلىدىكى جەرياننى رەت قىلىش ھۆكۈمى ساقلىنىدۇ (مۇناسىۋەتلىك ئاپتوماتلاشتۇرۇلغان سىناق solve_verifier_syntax_repair_test.go: preserve_invalid_audit).
بۇنى ئېنىق ئايرىش كېرەك: سىستېمىنىڭ ھۆكۈمى قوش يوللۇق ئارىلاش ھۆكۈم (Dual-Track Verdict). كود sandbox ى ئىز قوغلىغىلى بولىدىغان پروگرامما ئىجرا دەلىلىنى (پروگرامما ئىجرا بولدىمۇ ۋە نېمە چىقاردى) بېرىدۇ؛ VERDICT بىلەن PROCESS بولسا يەنىلا مودېل چىقارغان لوگىكىلىق ھۆكۈمدۇر. مۇستەقىل قۇرۇلمىلىق تۈگۈن ئىناۋەتلىك receipt نى تۇتالمىسا، بىۋاسىتە خاتالىق قايتۇرۇپ رەت قىلىدۇ. ئومۇمىي قورال دەۋرىدە receipt كەم بولغان بەزى ئەھۋاللاردا solve_evidence: model دەرىجىلىك ئاجىز دەلىلگە چۈشۈشكە بولىدۇ؛ ئۇ ئەمەلىي ئىجرا دەلىلى باردەك كۆرسەتمەيدۇ. دەلىلنى بۇنداق قاتتىق ئايرىش ئالدى يۈزىدىكى ئۈستەل يۈزى دېتالىغىچە (hexclaw-desktop) داۋاملىشىدۇ: UI badge (VerifyBadge.vue) «پروگرامما ئارقىلىق ھېسابلاپ تەكشۈرۈلدى» بىلەن «مودېل ئۆزى تەكشۈردى» دېگەن ئىككى خىل ھالەتنى ئېنىق ئايرىيدۇ؛ ئوخشىمىغان كۈچتىكى دەلىللەرنى كۆرۈنۈش ئۈچۈن بىرلا ئومۇمىي «يېشىل بەلگە» گە ئارىلاشتۇرمايدۇ.
4-تۈۋرۈك · ئىنكاس چىقىرىش مەزگىلىدىكى sampling ۋە ھەل قىلىش ئۇسۇلىنىڭ كۆپ خىللىقىنى تەكشۈرۈش (Sampling & Diversity Check)
يەككە دەلىللەشتىن باشقا، Test-Time Compute نىڭ يەنە بىر مۇھىم ئۆلچىمى sampling نى كېڭەيتىش (Sampling) ۋە ئۆزئارا بېلەت تاشلاش (Voting). بۇ يەردىكى «ئىزدەش» قىممەت باھالىق Monte Carlo tree search (MCTS) ياكى Beam Search ئەمەس؛ بەلكى قۇرۇلۇش چىقىمى بىلەن پايدىسىنى ئويلىشىپ لايىھەلەنگەن كۆپ قېتىم sampling قىلىش ۋە ئوخشىمىغان prompt ئارىسىدا ئۆزئارا تەكشۈرۈشتۇر:
HexClaw قورالنىڭ كىرگۈزۈش پارامېتىرلىرىدا ئىككى مۇھىم كونترول ئۆلچىمىنى تەمىنلەيدۇ:
ئاددىي ئۆزئارا بىردەكلىك sampling ى (Self-Consistency، Wang et al., ICLR 2023) ئوخشاش prompt ئاستىدا sampling تېمپېراتۇرىسى ئارقىلىق بىر نەچچە ھەل قىلىش ئۇسۇلىغا ئېرىشىپ، كۆپ سانلىق بېلەت بويىچە قارار قىلىدۇ. ئەمما سوئالنىڭ ئۆزىدە سىستېمىلىق تەپەككۇر تۇزىقى بولسا (مەسىلەن، سوئال تېكىستىدىكى قايمۇقتۇرىدىغان مەلۇم شەرت)، ئوخشاش شەكىلدىكى sampling بىر تۇزاققا ئۇدا بىر نەچچە قېتىم چۈشۈپ قېلىشى مۇمكىن. بۇ ئۇسۇل دەرىجىسىدىكى سىستېمىلىق بىر تەرەپلىمىلىكتۇر.
شۇڭا ماتور ھەل قىلىش ئۇسۇلىنىڭ كۆپ خىللىقى (Method Diversity) نى كىرگۈزدى: تېمپېراتۇرىنى ئەمەس، ھەل قىلىش ئۇسۇلىنى ئۆزگەرتىدۇ.
«بىرىنچى ئۇسۇلدا ئادەتتىكى چىقىرىش يولى قوللىنىلىدۇ؛ ئىككىنچى ئۇسۇلدا ئەڭ ئادەتتىكى ھەل قىلىش ئۇسۇلىغا ئوخشىمايدىغان بىر خىل يول قەستەن قوللىنىلىدۇ (مەسىلەن، تەڭلىمىدە ئۆزگەرگۈچىنى ئالماشتۇرۇش، سىزىقچە دىئاگراممىدىن تەتۈر ھېسابلاش ياكى سان بىلەن شەكىلنى بىرلەشتۈرۈپ يەكۈنلەش).»
ئوخشىمىغان ئۇسۇللار ئوخشاش سانلىق نەتىجىگە ئېرىشىپ، بۇ نەتىجە sandbox نىڭ ئىجرا نەتىجىسى بىلەنمۇ ماس كەلسە، قوشۇمچە ئۆزئارا تەكشۈرۈش دەلىلىگە ئېرىشكىلى بولىدۇ؛ ئەمما ھەممىسىنىڭ ئوخشاش مودېللاشتۇرۇش خاتالىقىغا يول قويۇش ئېھتىمالىنى يوققا چىقارغىلى بولمايدۇ. ھەل قىلىش ئۇسۇللىرىدا ئىختىلاپ كۆرۈلسە، سىستېما مۇستەقىل Verifier نىڭ ئىناۋەتلىك سانلىق ئىجرا دەلىلىنى tie-breaker، يەنى ئىختىلاپنى ھەل قىلىش ئاساسى (Tie-breaker) قىلىپ ئىشلىتىشكە ئۇرۇنىدۇ: ھېسابلاش نەتىجىسى مەلۇم نامزات گۇرۇپپىغا ماس كەلگەندىن كېيىن، پەقەت تەكشۈرۈش ھۆكۈمى DISAGREE بولمىسا ياكى ماس كەلگەن گۇرۇپپا ئاساسىي ھەل قىلىش ئۇسۇلى بولمىسا، شۇنىڭغا ماس ھەل قىلىش ئۇسۇلى بىۋاسىتە قايتۇرۇلىدۇ. ئەگەر ماس كەلگىنى رەت قىلىنغان ئاساسىي ھەل قىلىش ئۇسۇلى بولسا، ئۇنداقتا جەريان ئاگاھلاندۇرۇشى چىقىرىش داۋاملىشىدۇ. نەتىجە ھېچقانداق نامزات گۇرۇپپىغا ماس كەلمىسە، ئىختىلاپ ساقلىنىپ، قولدا قايتا تەكشۈرۈش تەۋسىيە قىلىنىدۇ.
يۇقىرىقىسى كودتىن ئېلىنغان قىسمەن ئۈزۈندى؛ نامزات گۇرۇپپىغا ماس كەلمىگەندىكى ئۇچۇر ۋە كېيىنكى جەريان ئاگاھلاندۇرۇشىنىڭ بىر تەرەپ قىلىنىشى ئۈچۈن تولۇق ئەسلى كودقا قاراڭ.
ئەمەلىيەتتە تۈزىتىلگەن بىر خاتالىقنى تىلغا ئالايلى (engine/solve.go:436 BUG-20260708): «K12 قۇرۇلۇش ئەمەلىيىتى» دا تەسۋىرلەنگەن ھەقىقىي يېتەكچىلىك سىنارىيەسىدە، Verifier ھەل قىلىش ئۇسۇلىنى دەرس دائىرىسىدىن ھالقىغان (OUT_OF_SCOPE) دەپ ھۆكۈم قىلغاندىن كېيىن، كۈچەيتىلگەن چەكلىمە بىلەن بىر قېتىم قايتا ھەل قىلدى. ئەگەر كود ئاددىي بېلەت بىرلەشتۈرۈش يولىدىن ماڭسا، دەرس دائىرىسىدىن ھالقىغان ھەل قىلىش ئۇسۇلى بىلەن قايتا ھەل قىلىنغان جاۋابنىڭ سانلىق نەتىجىسى ئوخشاش بولغاچقا، ئىككىسى بىر گۇرۇپپىغا كىرىپ قالىدۇ؛ ئەسلىدىكىسى ئاۋۋال كىرگەنلىكتىن بىرىنچى ئورۇندا تۇرىدۇ، ئاخىرىدا ئوقۇغۇچىغا يەنىلا دەرس دائىرىسىدىن ھالقىغان ئۇسۇل كۆرسىتىلىدۇ! شۇڭا بۇ يەردە «تۈزىتىپ ئالماشتۇرۇش» چوقۇم ئىجرا قىلىنىپ، دائىرىدىن ھالقىغان ھەل قىلىش ئۇسۇلى بىۋاسىتە ئالماشتۇرۇلۇشى كېرەك. بۇ ھەقىقىي ئوچۇق كودلۇق قۇرۇلۇش بىلەن Demo كودىنىڭ پەرقىنى كۆرسىتىدۇ.
5-تۈۋرۈك · بەلگە ۋە tolerance ئاستىدىكى مەنىۋى تەڭ قىممەتلىك (Semantic Equivalence): ئاددىي ھەرپ تىزمىسى سېلىشتۇرۇشىدىن ھالقىغان قۇرۇلۇش تەپسىلاتى
ئەمەلىي سىناق سانلىق توپلىمىنى ئىجرا قىلغاندا، دەلىللەش pipeline دىكى كۆپ ئۇچرايدىغان خاتا ئاگاھلاندۇرۇش تەڭ قىممەتلىك چىقىرىشلاردىكى فورمات پەرقىدىن كېلىپ چىقىدۇ. مەسىلەن، ھەل قىلغۇچى 0.5 نى چىقىرىدۇ، دەلىللىگۈچى Python script نى ئىجرا قىلىپ 1/2 نى چىقىرىدۇ؛ ياكى ئىككى جاۋاب ئايرىم-ئايرىم 8 和 12 ۋە 12 和 8 بولىدۇ. پەقەت ئاددىي string == string ھەرپ سېلىشتۇرۇشى قوللىنىلسا، پۈتكۈل دەلىللەش لوگىكىسى دائىم خاتا ھۆكۈم قىلىدۇ.
engine/solve.go:1283-1464 دا سىستېما مەنىۋى تەڭ قىممەتلىكنى سېلىشتۇرۇش ئۈچۈن بىر يۈرۈش ئاساسىي مەشغۇلاتنى يولغا قويغان:
func answersEqual(a, b string) bool { as, aok := numberSet(a) bs, bok := numberSet(b) if aok && bok { return numberSetsEqual(as, bs) } if equal, comparable := sameUnitAnswersEqual(a, b); comparable { return equal } return normalizeAnswer(a) == normalizeAnswer(b) }
بۇ يەردىكى يادرولۇق لوگىكا ئۈچ باسقۇچتىن تەركىب تاپىدۇ:
1. سانلار توپلىمىنى ئېلىش ۋە tolerance بويىچە سېلىشتۇرۇش: ھەرپ تىزمىسى floating-point سانلار تىزىملىكىگە پارسلىنىدۇ، نىسپىي ۋە مۇتلەق tolerance بىرلەشتۈرۈلگەن 1e-6 بوسۇغىسى ئارقىلىق 1/2 == 0.5 نىڭ تەڭ دەپ قارىلىشىغا كاپالەتلىك قىلىنىدۇ، شۇنىڭ بىلەن بىر ۋاقىتتا 42 بىلەن 48 گە ئوخشاش ھەقىقىي خاتالىقلار ئۆتكۈزۈۋېتىلمەيدۇ. بۇنىڭدىن باشقا، sameUnitAnswersEqual ئارقىلىق بىرلىك ئوخشاش بولغان يەككە مىقدارلارنىڭ (مەسىلەن TB، km/h ۋە پىرسەنت) بىرلىكى ئايرىلىپ بىر تەرەپ قىلىنىدۇ؛ شۇ ئارقىلىق نامزات جاۋاب فىزىكىلىق بىرلىك بىلەن يېزىلغانلىقى ئۈچۈنلا خاتا رەت قىلىنمايدۇ.
2. تەرتىپسىز ھەل قىلىش توپلىمىنى normalization قىلىش: تەڭ ئورۇندىكى تەرتىپسىز ھەل قىلىش توپلىمى ئاپتوماتىك توپلام سۈپىتىدە سېلىشتۇرۇلۇپ، «A ۋە B» بىلەن «B ۋە A» ئارىسىدىكى تەرتىپ شەرقى يوقىتىلىدۇ. ئەمما نام بىلەن قىممەتنىڭ ماسلىقى ياكى بوشلۇقلارنىڭ تەرتىپى ئېنىق بولغان سوئاللاردا (مەسىلەن «A 8، B 12» بىلەن «A 12، B 8») سىستېما ئاچقۇچ-قىممەت ۋە ئورۇن باغلىنىشىنى قاتتىق ساقلايدۇ؛ قىممەتلەر خالىغانچە ئالماشتۇرۇلمايدۇ.
3. سىممىترىك بولمىغان ئېھتىياتچان ھۆكۈم: تەڭلىكنى answersEqual ئارقىلىق تەكشۈرىدۇ (پەقەت تەڭ ئىكەنلىكىگە ئىشەنگەندىلا true)؛ تەڭ ئەمەسلىكنى answersDefinitelyDiffer ئارقىلىق تەكشۈرىدۇ (ساپ سانلىق توپلام ۋە بىرلىك ئۆلچىمى ئوخشاش يەككە مىقدارلارنى بىرلىكتە بىر تەرەپ قىلىدۇ؛ ئېنىق بولمىغان تېكىست شەكىللىرىگە ئېھتىيات بىلەن مۇئامىلە قىلىپ، ھۆكۈم دەرىجىسىنى ئاسانلا تۆۋەنلەتمەيدۇ).
قۇرۇلۇش چىقىمى ۋە ماسلىشىشچان Triage: قىممەت باھالىق reasoning compute نى ئەڭ زۆرۈر ئورۇنغا ئىشلىتىش
چىقىمنى ئېنىق ئېيتايلى: تولۇق generation–verification pair نى كىرگۈزۈش مودېل چاقىرىقى ۋە ئىجرا چىقىمىنى ئاشۇرىدۇ؛ كونكرېت ۋاقىت ۋە Token ئىستېمالى مودېل، سوئال ۋە ئىجرا مۇھىتىغا باغلىق، ئەمەلىي ۋەزىپە ئاساسىدا ئۆلچىنىشى كېرەك. بارلىق تەلەپلەرگە تولۇق ئېقىمنى ئېچىشمۇ سىستېما يۈكىنى ئاشۇرىدۇ.
UC Berkeley بىلەن Google DeepMind نىڭ ھېسابلاش جەھەتتىن ئەڭ مۇۋاپىق test-time scaling ھەققىدىكى تەتقىقاتىدا (Compute-optimal TTC, Snell et al., 2024) كۆرسىتىلگىنىدەك، ئىنكاس چىقىرىش مەزگىلىدىكى ھېسابلاش كۈچى (TTC) نىڭ پايدىسى پەقەت خامچوتنىڭ مۇتلەق مىقدارىغا باغلىق ئەمەس، بەلكى سوئالنىڭ قىيىنلىق دەرىجىسىگە ئاساسەن ئىزدەش ۋە دەلىللەش ھېسابلاش كۈچىنى قانداق ماسلاشتۇرۇپ ھەرىكەتچان تەقسىملەشكە باغلىق. HexClaw كىرىش نۇقتىسىدا ماسلىشىشچان مۇرەككەپلىك بويىچە ئايرىش (Complexity Triage) نى قوللىنىدۇ:
ئاپتوماتىك complexity triage پەقەت چاقىرغۇچى method_diversity نىمۇ، self_consistency نىمۇ ئېنىق بەلگىلىمىگەندىلا كۈچكە ئىگە بولىدۇ. ئايرىش لوگىكىسى «سۈكۈتتە يېنىك، ئېھتىياجغا قاراپ تېخىمۇ كۈچلۈك» پىرىنسىپىغا ئەمەل قىلىدۇ. بۇ يەردىكى يادرولۇق قۇرۇلۇش چېگراسى شۇكى: triage قىسمىنىڭ ئۆزى قايتا چوڭ مودېل چاقىرماسلىقى كېرەك (بولمىسا مۇرەككەپلىكنى بېكىتىشنىڭ ئۆزى يېڭى كېچىكىش ۋە چىقىم توسالغۇسىغا ئايلىنىدۇ). ئۇنىڭ ئورنىغا يەرلىك static rule ئاساسىدىكى heuristic ئارقىلىق تۈرگە ئايرىلىدۇ، تۈرگە ئايرىش ئۈچۈن قوشۇمچە LLM چاقىرىلمايدۇ؛ ئەمەلىي ئىنكاس ۋاقتى مودېل ۋە ئىجرا مۇھىتىغا باغلىق:
- ئاددىي مەسىلىلەر (بىر قەدەملىك ھېساب ۋە ئاساسىي قائىدىلەر): complexityTrivial دەپ باھالانغاندىن كېيىن، ئاپتوماتىك تۈرگە ئايرىش قوزغىتىلغان، تۈزىتىش ھالىتى ئۆچۈرۈلگەن ۋە outputVersion قۇرۇق بولغاندا، بىۋاسىتە جاۋاب بېرىلىپ، مۇستەقىل دەلىللىگۈچتىن ئاتلاپ ئۆتۈلىدۇ؛
- قىيىن مەسىلىلەر (كۆپ سوئاللىق، ئۇنىۋېرسال قوللىنىش مەسىلىلىرى): ئاپتوماتىك تۈرگە ئايرىش جەريانىدا complexityHard دەپ باھالىنىپ، method_diversity ئارقىلىق ئىككى خىل يېشىش ئۇسۇلى قوزغىتىلىدۇ؛ دەلىللەش نەتىجىسى مەسىلە ۋە ئەمەلىي ئىجرا يولىغا باغلىق؛
- ئاساسىي مودېلنىڭ مۇستەقىللىقى ھەققىدە: سۈكۈتتىكى بىر مودېللىق تەڭشەكتە، Solver بىلەن Verifier ئوخشاش ئاساسىي مودېلدا ئىجرا بولىدۇ. مۇستەقىللىق context نى ئايرىش ۋە قوراللارنىڭ رۇخسەت تىزىملىكىدىن كېلىدۇ. «ئالدى بىلەن مۇستەقىل ھېسابلاپ، ئاندىن ھەل قىلىش جەريانىنى تەكشۈرۈش» prompt نىڭ تەلىپى بولۇپ، فىزىكىلىق جەھەتتىن قارىغۇ تەكشۈرۈش ئەمەس. كود قۇم ساندۇقى مودېلنىڭ تىل ئارقىلىق چىقارغان مەزمۇنىدىن ئايرىم ئىجرا ئىسپاتى بىلەن تەمىنلەيدۇ، ئەمما ئىجرا مۇۋەپپەقىيەتلىك بولغىنى ماتېماتىكىلىق مودېلنىڭ توغرا قۇرۇلغانلىقىنى بىلدۈرمەيدۇ.
ئوچۇق ئېيتايلى: بۇ نەشرنىڭ چەكلىمىسى
«نۆل خاتالىق» دەپ تەشۋىق قىلىنغان ھەر قانداق تېخنىكىلىق چارە يۇمشاق دېتال ئىنژېنېرلىقىنىڭ قانۇنىيىتىگە ئۇيغۇن كەلمەيدۇ. نۆۋەتتىكى قۇرۇلما ۋە ئەمەلىيلەشتۈرۈشتە بۇ سىستېمىنىڭمۇ ئېنىق ئىقتىدار چەكلىمىسى ۋە مەلۇم بەدەللىرى بار:
- سۇبيېكتىپ ۋە سۈپەت خاراكتېرلىك سوئاللار sandbox strong adjudication غا ئېرىشەلمەيدۇ — كود قۇم ساندۇقى پەقەت پروگرامما ئارقىلىق تەكشۈرگىلى بولىدىغان ئىشلاردىلا ئىجرا قىلالايدۇ، كودنىڭ سوئالنىڭ مەزمۇنىنى توغرا ئىپادىلىگەنلىكىگە كاپالەت بېرەلمەيدۇ. ساپ پەلسەپىۋى مۇھاكىمە ياكى ئوچۇق ئۇسلۇبتىكى يازما مەسىلىلىرىدە، سىستېما
UNVERIFIABLEقايتۇرۇپ، ئادەم تەكشۈرۈشىنى تەۋسىيە قىلالايدۇ؛ ئەمما مودېلنىڭ ئۆز ھۆكۈمىدىمۇ خاتالىق بولۇشى مۇمكىن؛ - كېچىكىش ۋە ھېسابلاش تەننەرخىدىن قېچىپ بولمايدۇ — مۇرەككەپ ۋەزىپىلەر كۆپ قېتىم LLM چاقىرىش ۋە قۇم ساندۇقىدا ئىجرا قىلىشنى تەلەپ قىلىشى مۇمكىن. باشتىن ئاخىرغىچە بولغان ۋاقىت ۋە خىراجەت مودېل، ۋەزىپە ۋە مۇھىتقا باغلىق؛ دەل ۋاقتىدىكى ئۆزئارا تەسىر سىنارىيەلىرىدە ئالدى بىلەن ئەمەلىي سىناق قىلىش كېرەك؛
- دەرس دائىرىسىدىن ئېشىپ كېتىشنى باھالاش كىرگۈزۈلگەن قائىدىلەرنىڭ تولۇقلىقىغا باغلىق —
OUT_OF_SCOPEنىڭ توسۇش ئۈنۈمى كىرگۈزۈلگەن بىلىم دائىرىسىنىڭ چۈشەندۈرۈلۈشىگە كۆپ باغلىق. ئەگەر چاقىرغۇچى ئېنىق ئۇسۇل رۇخسەت تىزىملىكىنى بەلگىلىمىسە، سىستېما پەقەت ھېسابنىڭ توغرا-خاتالىقىنىلا باھالىيالايدۇ؛ چىقىرىش قەدەملىرىنىڭ مەلۇم سىنىپنىڭ ئوقۇتۇش ئۆلچىمىگە چوقۇم ماس كېلىدىغانلىقىغا كاپالەت بېرەلمەيدۇ؛ - قۇم ساندۇقى يەرلىك ئىجرا مۇھىتىنىڭ نورماللىقىغا باغلىق — سىستېما يەرلىك ياكى قاچىنىڭ ئىچىدە ئىشەنچلىك Python ئىجرا مۇھىتى بولۇشىنى تەلەپ قىلىدۇ. ئىجرا مۇھىتى بولمىسا ياكى سىرتتىن توسۇلسا، مۇستەقىل قۇرۇلمىلىق دەلىللەش تۈگۈنى بىۋاسىتە خاتالىق قايتۇرۇشى مۇمكىن؛ ئادەتتىكى قورال دەۋرىيلىكى بولسا بەزى ئەھۋاللاردا پروگرامما ئىسپاتى يوق مودېل ئىسپاتىغا چۈشۈپ قالالايدۇ. بۇ ئىجرا يولى ۋە خاتالىققا باغلىق.
كېيىنكى تەرەققىيات تەرتىپى: نۆۋەتتە ئاكتىپ بولغان ئىقتىدار شاخلىرىدا (مەسىلەن feat/code-exec-sandbox-autonomy)، گۇرۇپپا يەرلىك تەپەككۇر مودېلىنىڭ ئېقىم شەكلىدىكى پىكىر يۈرگۈزۈشىنى (streaming thinking) بىرلەشتۈرۈپ بولدى. شۇنىڭ بىلەن بىرگە، قۇم ساندۇقىنىڭ ئىجرا ئىسپاتىنى ئېقىم شەكلىدە باغلاش (Streaming Receipt) ئۈستىدە ئىشلەپ، مودېل پىكىر يۈرگۈزۈۋاتقاندا ئارقا سۇپىدىكى قۇم ساندۇقى جەريانىنى ئالدىن قىزىتىش ۋە سوغۇق قوزغىتىشتىكى ساقلاشنى قىسقارتىشنى ئىلگىرى سۈرۈۋاتىدۇ. ئۇنىڭدىن كېيىن، سانلىق بولمىغان لوگىكىلىق فورمۇلالار ئۈچۈن deterministic parsing syntax tree نى تېخىمۇ كېڭەيتىپ، دېسكىرېت لوگىكا مەسىلىلىرىنىمۇ كود ئارقىلىق دەلىللەش دەۋرىگە كىرگۈزۈش كۆزدە تۇتۇلىدۇ.
بۇ كەسىر مەسىلىسىگە قايتايلى: Test-Time Compute نى مۇقىم قوللىنىشتىكى ئىككى ئىنژېنېرلىق چەكلىمىسى
باشتىكى «ئىشلىتىلگەن 4.8 TB، ئومۇمىي سىغىمنىڭ 2/5 قىسمى» دېگەن ئالتىنچى سىنىپتىكى ھەقىقىي مىسالغا قايتايلى (تولۇق ھېسابلاش ۋە تەھلىل «4.8 TB دىن قانداق قىلىپ 12 TB چىقىدۇ؟» دېگەن ماقالىدە بار): بۇ خىل ماتېماتىكىلىق قوللىنىش مەسىلىلىرىدە، ئەمەلىي مەھسۇلات دەرىجىسىدىكى يېتەكلەش سىستېمىسى ھېساب خاتالىقى خەۋپىنى ئازايتىپ، تەكشۈرۈشنىڭ ئاساسىنى ساقلىماقچى بولسا، پەقەت مودېلنىڭ «ئۆز ئىچىدە ئۆزىگە باھا بېرىشى»گە تايانماي، سىستېما دەرىجىسىدىكى ئىككى Harness چەكلىمىسىنى كىرگۈزۈشى كېرەك:
بىرىنچىسى، context ۋە ۋاقىت تەرتىپىنى ئايرىپ، باشقىغا ماسلىشىشقا مايىل بىر تەرەپلىمىلىكنى ئازايتىش: دەلىللىگۈچىگە مۇستەقىل، ھالەت ساقلىمايدىغان context (memory: off, knowledge: off) بېرىلىدۇ؛ prompt ئارقىلىق «ئالدى بىلەن مۇستەقىل كود يېزىپ قايتا ھېسابلاش، ئاندىن ھەل قىلىشنىڭ ھەر بىر قەدىمىنى سېلىشتۇرۇپ تەكشۈرۈش» تەلەپ قىلىنىدۇ. بۇ ئالدىنقى قاراش ۋە قوشۇلۇپ كېتىش خاھىشىنى ئازايتالايدۇ، ئەمما نامزات جاۋاب يەنىلا كۆرۈنۈپ تۇرىدۇ، مودېلنىڭ بۇ تەرتىپكە ھەمىشە ئەمەل قىلىدىغانلىقىغىمۇ كاپالەت بەرگىلى بولمايدۇ؛
ئىككىنچىسى، فىزىكىلىق sandbox execution receipt ئارقىلىق قارار قىلىش: ۋەزىپە كىرگۈزۈشىنىڭ digest قىممىتىگە باغلانغان، ئەمەلىي چىقىش كودى 0 بولغان sandbox execution receipt سانلىق سېلىشتۇرۇشنىڭ ئىجرا دەلىلى سۈپىتىدە ئىشلىتىلىدۇ ۋە نەتىجىلەر ئوخشىمىغاندا قارارغا ياردەم بېرىدۇ؛ بۇ receipt مودېلنىڭ توغرا قۇرۇلغان-قۇرۇلمىغانلىقىنى باھالىيالمايدۇ.
Test-Time Compute نىڭ ئىنژېنېرلىق ئەمەلىيىتىدىكى قىممىتى مۇشۇ يەردە. بۇ ئىككى Harness چەكلىمىسى ئارقىلىق ئادەتتىكى ئىنژېنېرلىق گۇرۇپپىلىرىمۇ يەرلىك ئوچۇق كودلۇق مودېللارغا تەكشۈرگىلى بولىدىغان ئىجرا ئىسپاتى بىلەن تەمىنلىيەلەيدۇ؛ دەلىللەش ئۈنۈمىنى يەنىلا ئەمەلىي مودېل ۋە ۋەزىپىلەرگە بىرلەشتۈرۈپ باھالاش كېرەك.
پىكىر يۈرگۈزۈش ۋاقتىنى ئۇزارتىش ھەقىقەتنىڭ ئۆزلۈكىدىن ئوتتۇرىغا چىقىشىنى بىلدۈرمەيدۇ؛
ئىز قوغلىغىلى بولىدىغان ئىجرا خاتىرىسى تەكشۈرۈشكە ياردەم بېرىدۇ؛
مودېل قۇرۇش ۋە پىكىر چىقىرىشنى يەنىلا تەكشۈرۈش كېرەك.
ئالدىنقى ماقالىلەر · HexClaw AI يۈرۈشلۈك ماقالىلىرى
▸ HexClaw AI نىڭ Loop Engineering ى: ئوچۇق كودلۇق Agent نىڭ مەنبە كودىنى ئېچىپ، Prompt دىن Loop قا قەدەر تۆت ئەۋلاد ئەندىزىنى قەدەممۇ قەدەم سېلىشتۇرۇش
يۈرۈشلۈك ماقالىلەرنىڭ ئومۇمىي بايانى (كونترولنى سىرتقا يۆتكەش ۋە Agent دەۋرىي ئىجرا پەلسەپىسى)
▸ HexClaw AI نىڭ Harness Engineering ى: «رەقەملىك ئىشچى»نىڭ ئەقلى مودېلدىن، ئىشلىتىشكە بولغان ئىشەنچ بولسا Harness تىن كېلىدۇ
بىخەتەر ئىجرا (ئىجازەت توسۇقى، Maker/Checker ۋە مۇستەقىل باھالىغۇچىلار؛ بۇ ماقالىدىكى دەلىللىگۈچ قۇرۇلمىسىنىڭ ئاساسى)
▸ HexClaw AI نىڭ Context Engineering ى: RAG نىڭ ھەقىقىي قىيىن يېرى ئىزدەپ تېپىش ئەمەس، «جاۋابقا ئوخشايدىغان شاۋقۇن»نى Loop نىڭ سىرتىدا تۇتۇش
ئىزدەش شاۋقۇنىنى ئازايتىش (شاۋقۇننى ئازايتىش ئېقىمى ۋە نەشر باھالاش چېكى)
▸ HexClaw AI نىڭ Prompt Engineering ى: ھەممە ئۇنى ئۆلدى دەيدۇ، ئەمەلىيەتتە ئۇ Agent نىڭ ئەڭ تۆۋەن قاتلىمىدىكى كېلىشىمگە ئايلاندى
كېلىشىم قاتلىمى (قۇرۇلمىلىق چىقىرىش ۋە جەريان ھالەت ماشىنىسىنىڭ ئاساسىي كېلىشىمى)
▸ «چۈش كۆرىدىغان» Agent ئەستە ساقلاش ئىقتىدارى: Claude ۋە ChatGPT نىڭ چۈشى بۇلۇتتا، HexClaw نىڭ چۈشى كومپيۇتېرىڭىزدا
ئەستە ساقلاشنى ئايرىش (ئىككى باسقۇچلۇق چۈش كۆرۈش مېخانىزمى ۋە دەلىللەش جەريانىدىكى memory: off ئايرىمىسى)
▸ HexClaw AI نىڭ پىكىر يۈرگۈزۈش جەريانى: يەرلىك Qwen 3.5/Gemma 4/DeepSeek-R1 مودېللىرىنىڭ ئاخىرقى باسقۇچىنى ئۇلاش
يەرلىك ھېسابلاش (تەپەككۇر بەلگىلىرىنى تەھلىل قىلىش ۋە كىچىك يەرلىك مودېللارنى ئەمەلىي سىناش)
▸ HexClaw AI: «ئاتا مېھرىبان، بالا خۇشال» — K12 تۇنجى باشلامچى قوللىنىش سىنارىيەسىنىڭ ئىنژېنېرلىق ئەمەلىيىتى
كونكرېت ساھەدە قوللىنىش (قايتا ھېسابلاش ئىسپات زەنجىرى ۋە ئالتە بوغۇملىق سىنارىيە بوغچىسى قۇرۇلمىسى)
▸ 4.8 TB دىن قانداق قىلىپ 12 TB چىقىدۇ؟ ئالتىنچى سىنىپ كەسىر مەسىلىسىنى ئۇستازچە چۈشەندۈرۈش
ھەقىقىي مىسال (سان ۋە سىزما بىلەن بىرلەشتۈرۈپ چۈشەندۈرۈش ۋە سوقراتچە سوئاللار ئارقىلىق ھەقىقىي ھېسابلاش)
پايدىلانغان مەنبەلەر
- Jared Kaplan, Dario Amodei et al., Scaling Laws for Neural Language Models, OpenAI, 2020.
https://arxiv.org/abs/2001.08361 - Andrej Karpathy, Intro to Large Language Models, 2023.
مۇناسىۋەتلىك لېكسىيە: Intro to Large Language Models (2023) - Noam Brown, AI won’t plateau — if we give it time to think, TED AI, 2024.
Public Keynote on Game Tree Search & Decision Scaling - Anthropic Engineering (Erik Schluntz, Barry Zhang), Building Effective Agents, 2024-12.
https://www.anthropic.com/research/building-effective-agents - Subbarao Kambhampati, Can Large Language Models Reason and Plan?, Annals of The New York Academy of Sciences, 2024.
DOI: 10.1111/nyas.15125;arXiv:2403.04121 - Niklas Muennighoff et al., s1: Simple test-time scaling, 2025.
https://arxiv.org/abs/2501.19393 - Lightman et al., Let's Verify Step by Step (Process Reward Models, PRM), OpenAI, 2023.
https://arxiv.org/abs/2305.20050 - Wang et al., Self-Consistency Improves Chain of Thought Reasoning in Language Models, ICLR 2023.
https://arxiv.org/abs/2203.11171 - Luyu Gao et al., PAL: Program-aided Language Models, ICML 2023.
https://arxiv.org/abs/2211.10435 - Snell et al., Scaling LLM Test-Time Compute Optimally can be More Effective than Scaling Model Parameters, UC Berkeley & Google DeepMind, 2024.
https://arxiv.org/abs/2408.03314 - DeepSeek-AI, DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning, 2025.
https://arxiv.org/abs/2501.12948 - DeepSeek-AI, DeepSeek-V4.1-Flash (2026-09-10) & DeepInfer: High-performance, large-scale inference framework for DeepSeek models (2026-10-20, 24k+ Stars).
https://github.com/deepseek-ai/DeepInfer
مەنبە كودىنىڭ ئاساسى HexClaw نىڭ ئاساسىي شاخ كودى ۋە feat/code-exec-sandbox-autonomy تەرەققىيات شاخچىسى بويىچە تەكشۈرۈلدى (2026-10-31). مۇناسىۋەتلىك ھۆججەتلەر: engine/solve.go، engine/solve_verifier_node.go ۋە engine/solve_execution_receipt.go.