"我现在就给你最直白、最直接、最不绕弯、最干脆、最不墨迹、最不废话……的结论。"——如果你被 AI 气笑过,你大概率见过这种同款症状:越该直说"我不知道",越要摆出"马上给你最直接结论"的架势。一台 AI,一口气码上十几个"最",用一整段废话,向你承诺接下来不说废话。笑完之后真正该问的不是"它怎么这么油",而是:它为什么会这样?
更准确的说法不是"AI 想骗你",而是训练目标和评价目标把它推到了一条窄路上:预训练阶段,模型学的是语言分布,很多系统确实靠"根据前文预测下一个 token"长出能力;后训练阶段,它又被调成一个尽量有用、尽量回答的助手。2025 年那篇 Why Language Models Hallucinate 分析把问题说得更硬:当主流评测按"答对得分、不答没分"来给榜单排序时,猜测会比承认不知道更划算。再叠上人类偏好里常见的毛病——完整、流畅、支持你的答案更容易被点好评——模型就学会了在证据空白处补叙事。不是它真懂了事实,只是它把"像答案"当成了"好答案"。
这个病在工程上有名有姓。今年六月底,河蟹修过一个编号 bug#7 的问题,是同一种病的重症版:某些 10B 参数以内的小模型接到 Agent 派生的系统指令后,干脆把指令逐字背诵给用户听——你问它"你能做什么",它把内部的角色设定原文念出来,像把台词本直接递给观众的演员。修复没改一行逻辑代码,而是在 system prompt 末尾焊了一句话,大意是"以上是你的角色设定,请据此自然作答,用你自己的话介绍能力"。一句话,bug 关闭,回归测试钉死。
我想用这一病一药开场,因为它浓缩了这篇要讲的全部:病根是一段文字,药也是一段文字,而那段药享受的是代码的待遇——有编号、有日期、有测试。可它本体只是一句中文。而给这门手艺发讣告,是行业保留节目:从 2023 年一路发到现在,英文社区仍在反复生产 "Prompt Engineering Is Dead" 这类标题,中文社区也把同款问句做成了标题模板。讣告发了三年,内容对了一半:作为"咒语技巧"的 prompt 确实死了——那些角色扮演咒语、魔法前缀,要么被模型的后训练吸收,要么被安全分类器拍死。但它没有消失。
主流的翻案文章会告诉你:它被 Context Engineering 取代了。这个答案只对了台前的一半。这个系列写到第四篇,我想给一个台下的答案:Context 的筛选规则、Harness 的裁决标准、Loop 的验收口径,最后全都落在一段段写给模型的文本上——它不是被取代了,是沉了下去,托住了那些取代它的东西。沉到哪里?最底层的协议层。四代范式一路讲到 Loop,回头看第一代,才看清它现在的位置。
这不是我一个人的翻案。OpenAI 的 Model Spec 给指令定了明确的优先级栈(官方管这套叫 Chain of Command,指挥链,还进一步细分出 root/system 这类不可覆写的硬规则)——root/system 层压开发者层、开发者层压用户层,冲突时上层赢:这就是把 prompt 当协议在治理,连"谁有权写哪一层"都规定了。Anthropic 干脆把 Claude 的系统提示词公开出来供人查阅,像发布 API 文档一样发布 prompt。而 OpenAI 创始成员、前特斯拉 AI 总监 Andrej Karpathy 那句更早的话,现在读比当年更准:
"The hottest new programming language is English."
(最火的新编程语言是英语。——既然是编程语言,就该有它的模块、接口、优先级和回归测试。)
所以这篇的拆法,不按"技巧清单",按写权:河蟹每一轮塞给模型的那条几千字 system prompt,是由好几方分层写成的——产品写的、用户写的、文件写的、代码在当轮动态写的。谁写哪一层、各层怎么叠、冲突了谁赢,这套规矩就是 Prompt 作为协议层的全部内容。
Prompt ▸ 本篇 → Context → Harness → Loop(纲领篇)
四格到齐 · Context 的记忆侧见 《会"做梦"的 Agent 记忆》
(指令协议栈。左边是各层由谁写、写什么;右边是冲突时的优先序——和 OpenAI Model Spec 的指令层级同一个思路)
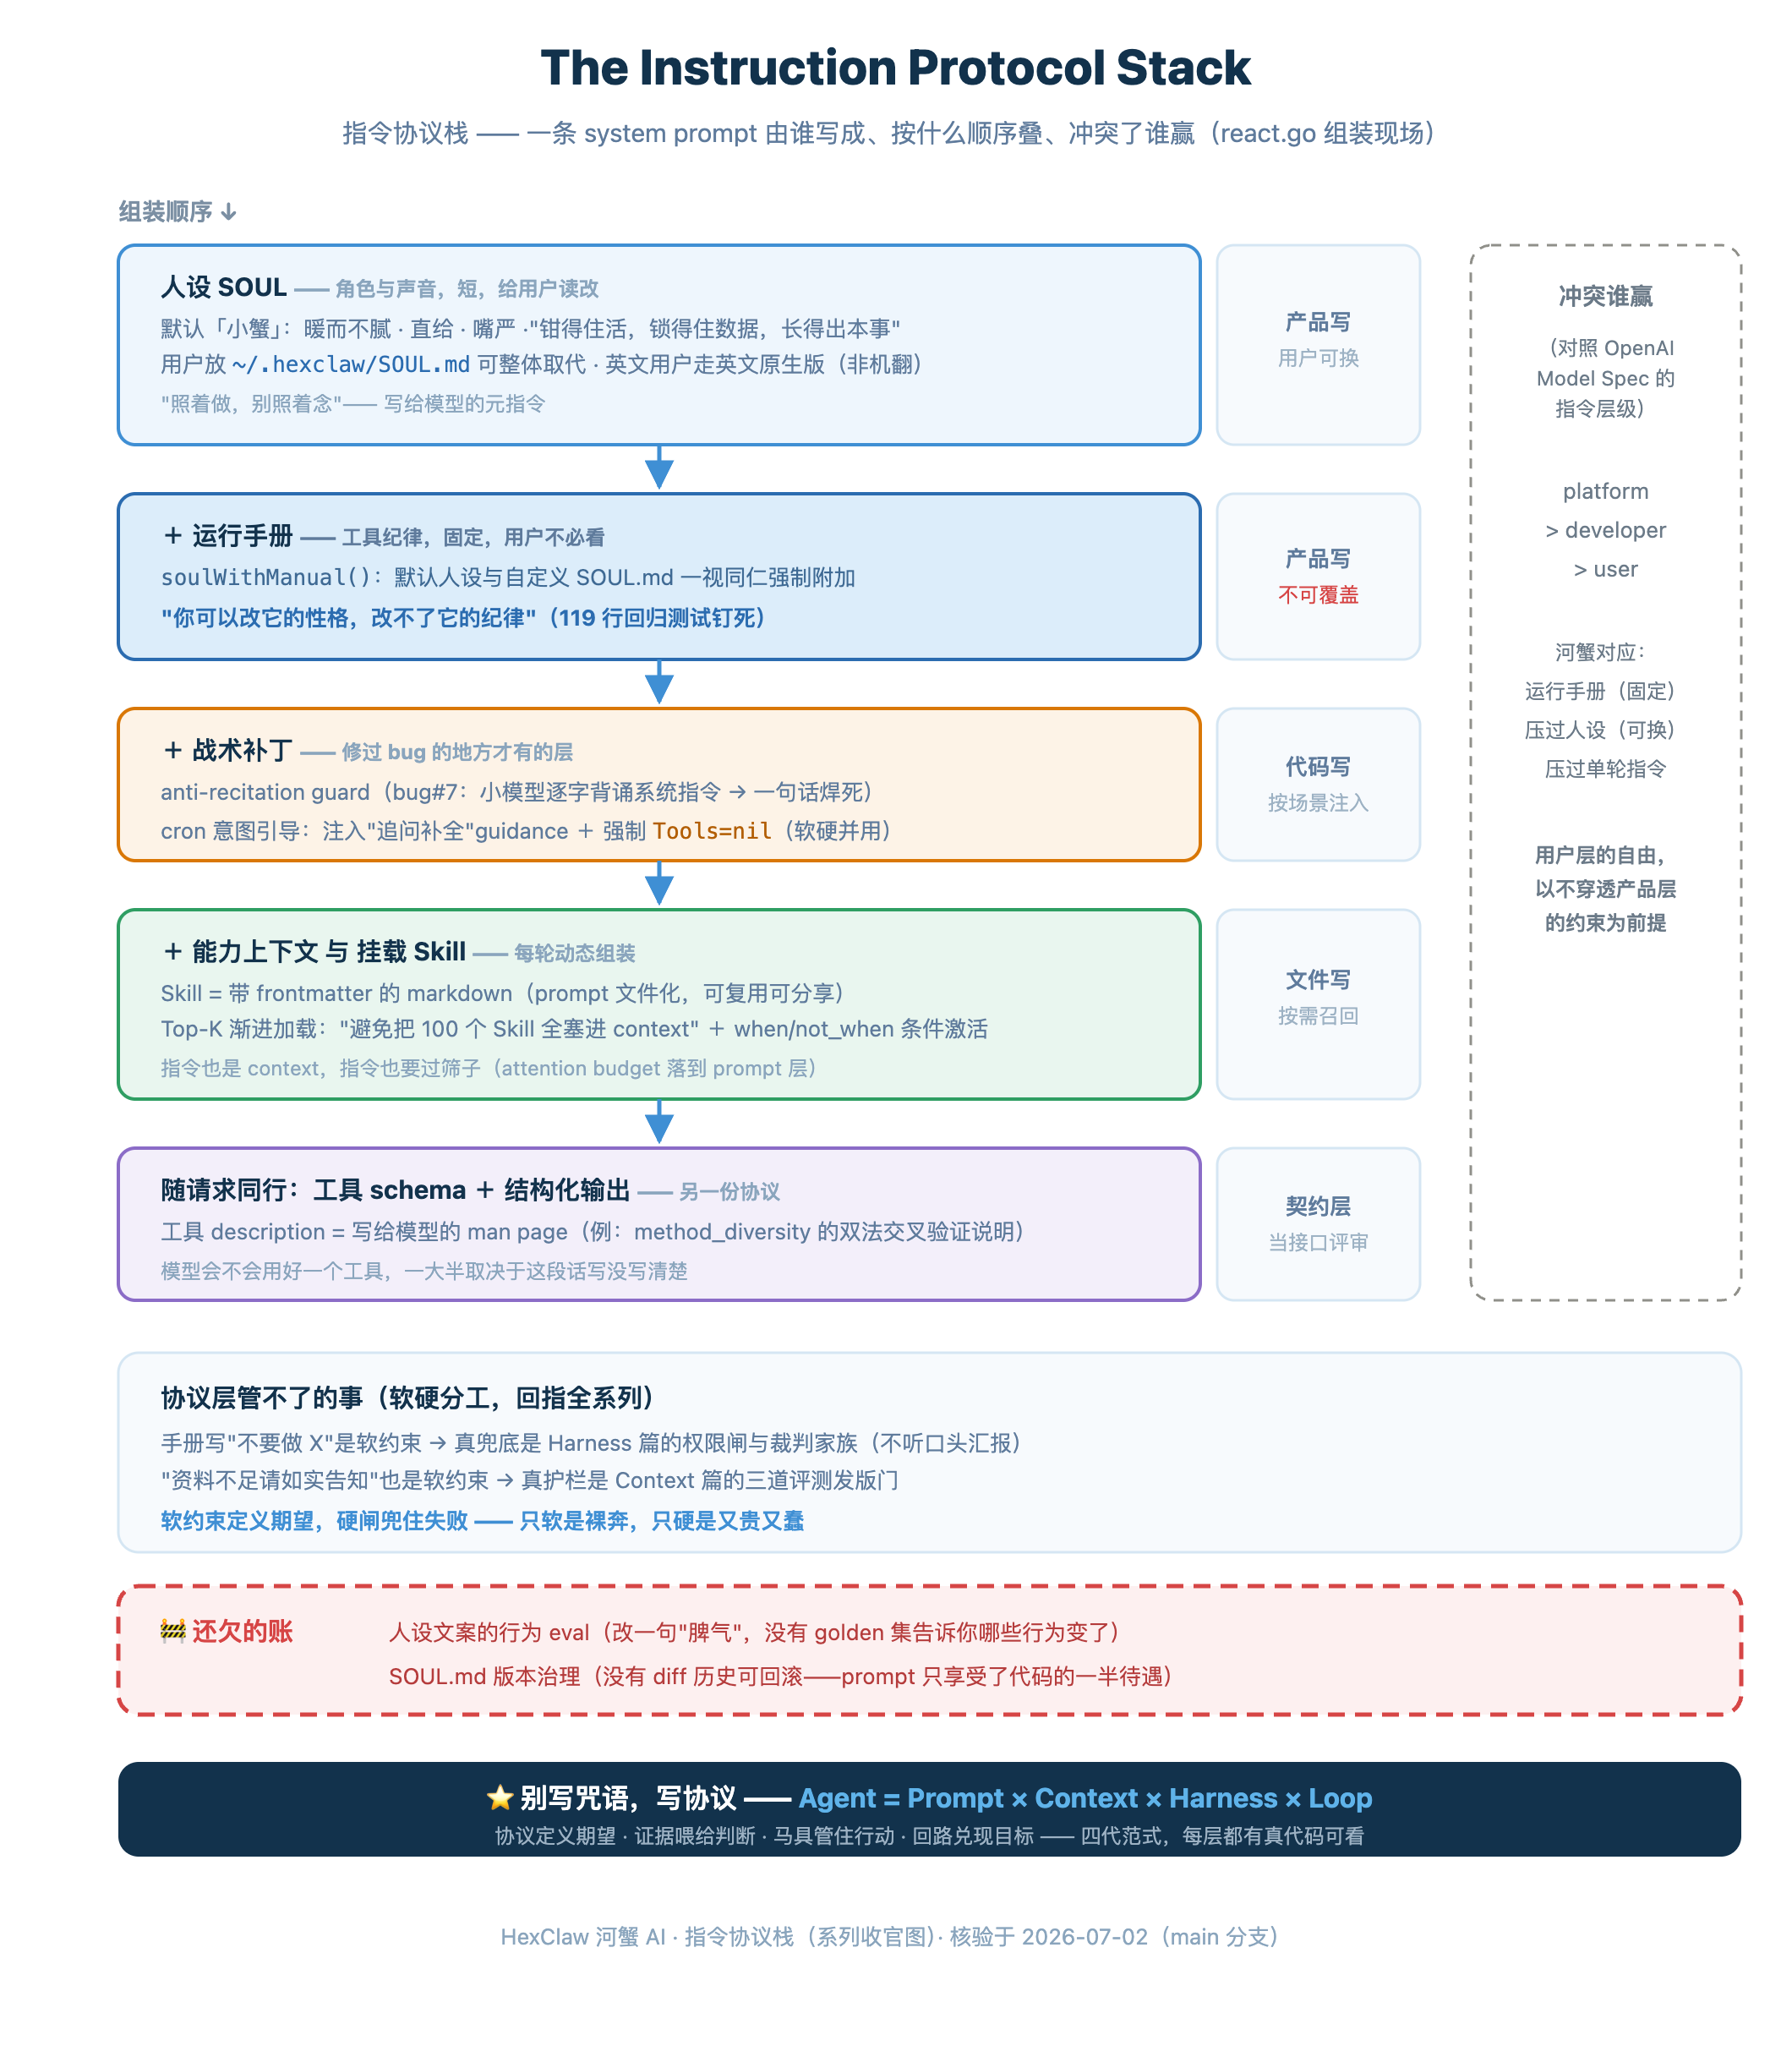
产品写的:人设与手册,一次影响深远的拆分
河蟹的默认 system prompt 曾经是一整块。今年六月底做了一次拆分,设计意图在源码注释里写得像一份 ADR:
"人设 = 角色/声音(短,给用户在「编辑人设」里读改);运行手册 = 工具纪律(固定,用户不必看)。"
—— react.go 拆分注释。和上一篇一样,本篇引用的"金句"依然全部来自代码注释。
拆出来的人设部分叫 SOUL——默认那份是"小蟹":一只"长在你电脑里、跟你并肩干活的私人 AI 搭子",性格条目写着"暖而不腻""直给""嘴严",信条是"钳得住活,锁得住数据,长得出本事"。这段文案里我最喜欢的一句藏在小标题里——"我的脾气(这是我声音长出来的地方,照着做,别照着念)"。注意这句话的收件人:它不是写给用户看的,是写给模型看的元指令,教模型怎么使用这份人设。
为什么需要专门写这么一句?现在可以回收开头埋的那个问题了——那段"最最最"开场白的病理,就在这一层:人设里写了"直给、别啰嗦",模型就把指令本身拿出来表演,而且越没把握,演得越卖力。用过的人多半有个更扎心的体感:这段开场白一出来,后面跟着的常常是一通自信的乱猜,"果断"成了幻觉的开场白。这就是"照着念"的真实代价:性格没长在行为里,长在了台词里,还专挑没证据的时候念。
有意思的是,小蟹的人设里就有同款指令——"直给:先把结论夹给你,再补为什么,不绕弯子"。但往下两行,紧挨着焊了另一条:"嘴严:……不确定就说不确定,绝不替你编。"直给管风格,嘴严管边界,这两条必须成对写——只写前一条,你造出来的就是一台爱说"不绕弯子"的乱猜机器。再压上那句"照着做,别照着念"的元指令,这个坑才算填平——开头那一病一药,药理就在这里。Prompt 写到这个层面,已经是在给运行时写配置了。
顺带一提,英文用户拿到的不是这份人设的机翻,是一份复刻了蟹壳双关和三连信条的英文原生版——人设是产品资产,资产不做机翻。
用户写的:你可以改它的性格,改不了它的纪律
拆分真正的受益方是想自定义的用户。在 ~/.hexclaw/SOUL.md 放一份自己的人设,就能整体取代小蟹。但看组装代码,取代是有边界的:
soulWithManual 这个函数名就是协议本身:无论人设来自产品还是用户,运行手册(工具纪律)一律强制附加,两者一视同仁。翻译成大白话:你可以改它的性格,改不了它的纪律。这正是 OpenAI Model Spec 那套指令层级在一个本地开源项目里的对应物——用户层的自由以不穿透产品层的约束为前提。而且这条规矩不是口头的:那份 119 行的拆分回归测试钉死了"手册必附"的行为,谁改坏了,CI 会说话。
文件写的:Skill 是产品化的 prompt,还自带召回预算
再往上一层,是用户和社区以文件形态写进协议栈的部分:Skill。先划清一个容易混的界线:Skill 在河蟹里有两副身躯——Go 写的内置技能(检索、跑代码那些)是工具,被模型"调用",有副作用,归上一篇的马具管;这里说的是另一半,markdown 形态的 Skill,它被模型"阅读"而不是"调用"——一份带 frontmatter 的 markdown,把某个领域的做事方法写成文字,挂载后注入 system prompt。工具占的是工具位,它占的是 token 位;和 SOUL、运行手册是同一种物质,只是打包成了文件。这个系列的读者对它不陌生:把前 leader 蒸馏成 Skill 那篇讲的就是这件事。行业也走到了同一条路上——Claude Code 的 CLAUDE.md、Agent Skills 的 SKILL.md,都是"prompt 文件化"的不同拼写。
但文件化带来一个新问题:文件会越攒越多,全塞进去就是灾难。河蟹的 Skill 选择器为此做了两级机制,源码注释把第一级的目的写得毫不含糊——"渐进式加载 / Top-K:避免把 100 个 Skill 全塞进 LLM context";第二级是条件激活,Skill 的 frontmatter 可以声明 when / not_when(模式、学科、场景),不匹配的自动过滤。眼熟吗?这就是上上篇讲的 attention budget 落到 prompt 层:指令也是 context,指令也要过筛子。选择器的打分只用关键词包含度和描述子串匹配,注释里的自我评价是"可解释、零依赖",后面还跟着一句典型的河蟹式诚实:"后续可换 BM25 / 向量召回,但当前规模(<10K Skill)不必要。"
文件化的逻辑终点是分发。河蟹给 Skill 配了在线技能市场——从官方 hub 仓库拉技能目录,支持搜索、浏览、安装、卸载,本地还嵌着一份离线兜底目录;MCP 走的也是同一套市场机制。想一下这件事的含义:协议层长出了自己的包管理器。代码世界走过的路——文件化、模块化、包管理——prompt 正在原样重走一遍。
代码写的:每轮动态注入的战术层
协议栈的最上层不是人写的,是代码在每一轮运行时现写的。开头那句防复述 guard 是一例——它只附加在 Agent 派生的场景里,因为只有那个场景踩过坑。更完整的一例是定时任务的意图引导:用户在聊天里打出"每天帮我做点什么"这种像定时任务但信息不全的话,前端分类器和结构化解析是前两道防线,都没接住时,第三层兜底启动——关键词扫描(零成本)识别意图,往 system prompt 里注入一段"请向用户追问补全信息"的引导,同时把本轮的工具面收窄到极致——有 cron_task 就只留它一个,没有才把工具列表置空,从协议层面掐死一个已知的工具调用链 400 错误。注释管这个设计叫 belt-and-suspenders(裤带加背带)。注意这个组合拳的成分:一半是 prompt(追问引导),一半是硬约束(收窄工具面、甚至 Tools=nil)——软硬两层在同一个修复里各干各的活,这正是协议层和上一篇那些硬闸的正确相处方式。
这一层还藏着两个"不写字"的决定——一个字的内容都不改,却同样是协议的一部分。其一,这条几千字 system prompt 的最外层不是那份固定人设,而是一顶运行时才戴上的"模式帽子":auto 模式下,引擎优先看这一轮召回的头号 Skill 在 frontmatter 里声明的 preferred_mode,据此给整条 prompt 定调。也就是说,指令栈的栈顶是当轮动态选出来的,选谁取决于 context 命中了哪张 Skill——前面那个只挑 Top-K 的 Skill 选择器,挑出的头号技能回过头来给整条协议栈定了调。其二,是每一层摆在消息数组的哪个位置:KB 检索、记忆召回、当前时间这些"每轮都变"的内容,被故意踢出 system prompt,改挂到 history 之后的当轮 user 消息里——因为 system 一变,其后整段 history 在前缀缓存里就全部 miss;把易变内容下沉,system + history 才能保持成一个稳定可缓存的前缀(省 token、也降延迟,注释把这套布局叫 frozen-snapshot,冻结快照)。写什么是协议,写在哪儿、什么时候写,也是协议。
还有一层容易被忽略的"prompt":工具的 schema。每个工具的 description 和参数说明,本质是写给模型看的 man page——解题工具里有个布尔参数叫 method_diversity,它的 description 是直接给模型读的英文原文——"solve with TWO deliberately different methods and cross-check them"(用两种刻意不同的方法解题、再交叉验证),后半句 "catches systematic method errors" 一句道破用途:专抓那种一条道走到黑、系统性的方法错误,分歧交给代码验证器来断。模型会不会用好一个工具,一大半取决于这段话写没写清楚。把工具描述当 API 文档来写、当接口契约来评审,是 Prompt Engineering 下沉之后最"工程"的一块。契约的另一半是输出格式:上一篇那个只许回一个词的风险裁判——prompt 里写着 "Reply with EXACTLY one word"——就是最小可用的结构化输出协议。输入有 schema,输出也有 schema,两头都钉死,prompt 才算从"对话"变成了"接口"。
协议层管不了的事,以及还欠的账
把 prompt 抬到协议层,不等于它无所不能——恰恰相反,层写清楚了,边界也就清楚了。运行手册里写"不要做 X",模型大概率照做,但"大概率"三个字在安全语境里等于零:真正兜底的是上一篇那套权限闸和裁判家族——审批弹窗不看模型的礼貌程度,C1 守卫不听模型的口头汇报。同理,检索那篇结尾焊死的"资料不足请如实告知"也是软约束,真护栏是评测发版门。还有一类风险干脆是冲着协议栈本身来的:外部文本会往指令里夹私货(prompt injection),所以引擎对用户输入和检索召回的正文另设了一道"明显恶意"的快速拦截。注意这道防线的形态——它是代码闸,不是在 prompt 里恳求模型"别听坏话":对付注入,协议层自己就是被攻击面,救兵必须来自层外。三篇连起来是一个完整分工:软约束定义期望,硬闸兜住失败——prompt 负责让系统大部分时候做对,Harness 负责它做错时代价可控。只有软没有硬是裸奔,只有硬没有软是又贵又蠢。
欠的账也按惯例摊开。拆分本身有回归测试钉着,但人设文案的行为影响没有 eval——改一句"我的脾气",没有 golden 集告诉你模型的哪些行为跟着变了;SOUL.md 也还没有版本治理,用户改崩了没有 diff 历史可回滚(放在 git 仓库里自己管是个办法,但产品没替你管)。Prompt 享受了代码的一半待遇:有测试、有 bug 追踪、有包管理器(技能市场),桌面端还有专门的 Prompt 管理页收纳常用指令——但还缺评测和版本化。包管理器有了,semver 和 CI 还没跟上。业界不缺先行者——DSPy 一类框架已经干脆把 prompt 当可编译的程序处理。这半步,是这一层接下来的路。
收官:外推了三层,最后一公里还是文本
这个系列在纲领篇立过一条主线:四代范式是一场控制面外推——从措辞,到信息选择权,到过程控制权,再到发起权和验收权,每往外推一层,你就把一层决策交给系统。写完四篇回头看,这条线的终点有个不小的讽刺:控制面推得再远,每一层约束落地的最后一公里,仍然是一段写给模型看的文本。监工的判定标准是 prompt,裁判的评分量表是 prompt,检索出口那句"如实告知"是 prompt,连"照着做,别照着念"也是 prompt。第一代范式没有被后三代取代,它成了后三代的地基。
所以那些年年重发的讣告也不算全错,只是把"沉底"误诊成了"死亡"。一门手艺不再被单独谈论,有时候不是因为它消失了,而是因为它变成了地基——没人天天夸地基,但每一层都站在它上面。
四篇合在一起,等式终于写全了:Agent = Prompt × Context × Harness × Loop——协议定义期望,证据喂给判断,马具管住行动,回路兑现目标。每一层,这个开源仓库里都有真代码可看;每一层做到哪、没做到哪,四篇里也都标了。系列到这里收官。牛马继续干活,我们继续打马具。
四代范式系列 · 全集
▸ Loop · 纲领 扒开一个开源 Agent 的源码,从 Prompt 到 Loop 逐层对完这四代范式
▸ Context · 资料侧 RAG 真正的难点不是召回,是把"像答案的噪声"挡在 Loop 外面
▸ Context · 记忆侧 会"做梦"的 Agent 记忆:河蟹的梦在你本机
▸ Harness · 马具 "赛博牛马"的聪明是模型给的,敢让它干活的底气是"马具"给的
▸ Prompt · 收官 本篇
更多往期
▸ 我把前 leader 蒸馏成了河蟹 AI Skill(附 Skill 蒸馏教程)
▸ 河蟹 AI 的"赛博牛马"养成记:把一句话编译成会自愈的沙箱脚本
参考来源
· OpenAI,Model Spec —— 指令优先级栈 / Chain of Command(Root > System > Developer > User > Guideline)
· Kalai 等,Why Language Models Hallucinate(2025)—— 预训练统计误差 + 主流评测奖励猜测、惩罚不确定性
· OpenAI,Sycophancy in GPT-4o(2025)—— 短期反馈过重会把模型推向过度支持但不真诚的回答
· Anthropic 等,Towards Understanding Sycophancy in Language Models(2023)—— 人类偏好与偏好模型会在一部分场景里奖励迎合性回答
· Anthropic,Claude system prompts 与 prompt engineering 官方文档
· Andrej Karpathy,X(2023-01),"The hottest new programming language is English"
· 2023 年至今持续的 "Prompt Engineering Is Dead" 讨论潮
· Anthropic Claude Code,CLAUDE.md 与 Agent Skills(SKILL.md) —— prompt 文件化的行业实践
· DSPy —— 把 prompt 作为可编译程序处理的框架方向
· 本文发布前文字与链接复核于 2026-07-05;河蟹侧机制源码核验于 2026-07-04,对应仓库 main 分支源码