有一种回答,你大概也见过:Agent 一本正经地列出"参考 1(相关度:61%)",标题、来源一应俱全,然后基于这条参考给出一个错误的答案。它比裸幻觉毒得多——裸幻觉你还会将信将疑,带着出处感的错答会让你直接放下戒心。而它多数时候不是模型在编造,是检索链路把一条"话题相邻、但不含答案"的材料端了上来,模型只是忠实地消化了喂给它的东西。
在上一篇里我把河蟹的 Loop 层摊开讲了一遍:环会自己转了,监工对照目标判进度,不达成补派下一轮。写完那篇我就知道下一篇必须写什么——因为环转起来之后,一个原来不起眼的问题变成了系统性风险:环的每一轮都要吃 context。喂进一次噪声,在对话里是一次错;在 Loop 里,这次错会成为下一轮规划的输入,是复利。
这个视角行业里早就有名字了:Context Engineering——去年年中被几位行业大佬接力带火,到今天都快说滥了。说实话,这词刚刷屏那阵我当它是又一轮黑话通胀,一直没接这个茬——直到把河蟹知识库这条线整个撸完,才承认它描述的就是我在干的活。电商巨头 Shopify 的 CEO Tobi Lütke——最早把"AI 优先"写进全员备忘录的那批老板之一——给过一个挺准的定义,"the art of providing all the context for the task to be plausibly solvable by the LLM"(提供恰好足够的 context,让任务对 LLM 而言变得"有解");流传更广的是 OpenAI 创始成员、前特斯拉 AI 总监 Andrej Karpathy 那条:
"Context engineering is the delicate art and science of filling the context window with just the right information for the next step."
(Context engineering 是一门精细的手艺和科学:往 context 窗口里装的,恰好是下一步所需要的信息。)
留意一下,他们谁都没说"喂更多"。Anthropic 在工程博客里把话挑得更明:context 是稀缺资源,目标是找到 "the smallest possible set of high-signal tokens"(尽可能小的高信号 token 集合)。
这两年的实证也把这个方向砸实了。Chroma 团队给"塞得越多、越记不住"起了个名字叫 Context Rot:token 越多,模型从 context 里准确捞回信息的能力越差;Anthropic 顺着这条证据把注意力说成一种预算(attention budget),每塞一个 token 都在花这笔钱。Liu 等人的 Lost in the Middle 更早就发现长 context 中段的利用率是 U 型塌陷。但对做 RAG 的人来说,最扎心的是 SIGIR 2024 的 The Power of Noise:随机塞进来的无关文档几乎无害,真正把准确率拖垮的,是那些"话题相邻但不含答案"的干扰文档——恰好就是向量检索最爱捞回来的那种。
所以这篇不打算写"我的 RAG 召回率有多高"。RAG 的文章太多了,几乎全在讲怎么捞得更多。这篇讲反面,也是我在河蟹的知识库源码里花力气最多的地方:怎么扔得更狠。把检索链路六道工序逐个摊开——你会发现除了一道在做加法,其余全部在做减法:降权、设地板、去重复、收窄、逼它认账。
写完这篇,我最想让你带走的是一句话:检索系统的核心能力不是"找到",是"拒绝"。一条生产级的 RAG 链路,本质上是一条负责说"不"的流水线——它说"不"的每一处,都对应着一种真实的失败形态。
Prompt(压轴) → Context ▸ 本篇 → Harness(下篇) → Loop(纲领篇 · 已发)
Context 的另一半是记忆侧,见 《会"做梦"的 Agent 记忆》
(全景图。六道工序、一整条降级阶梯、三道评测门,常量都是从源码里抄的,一个没编)
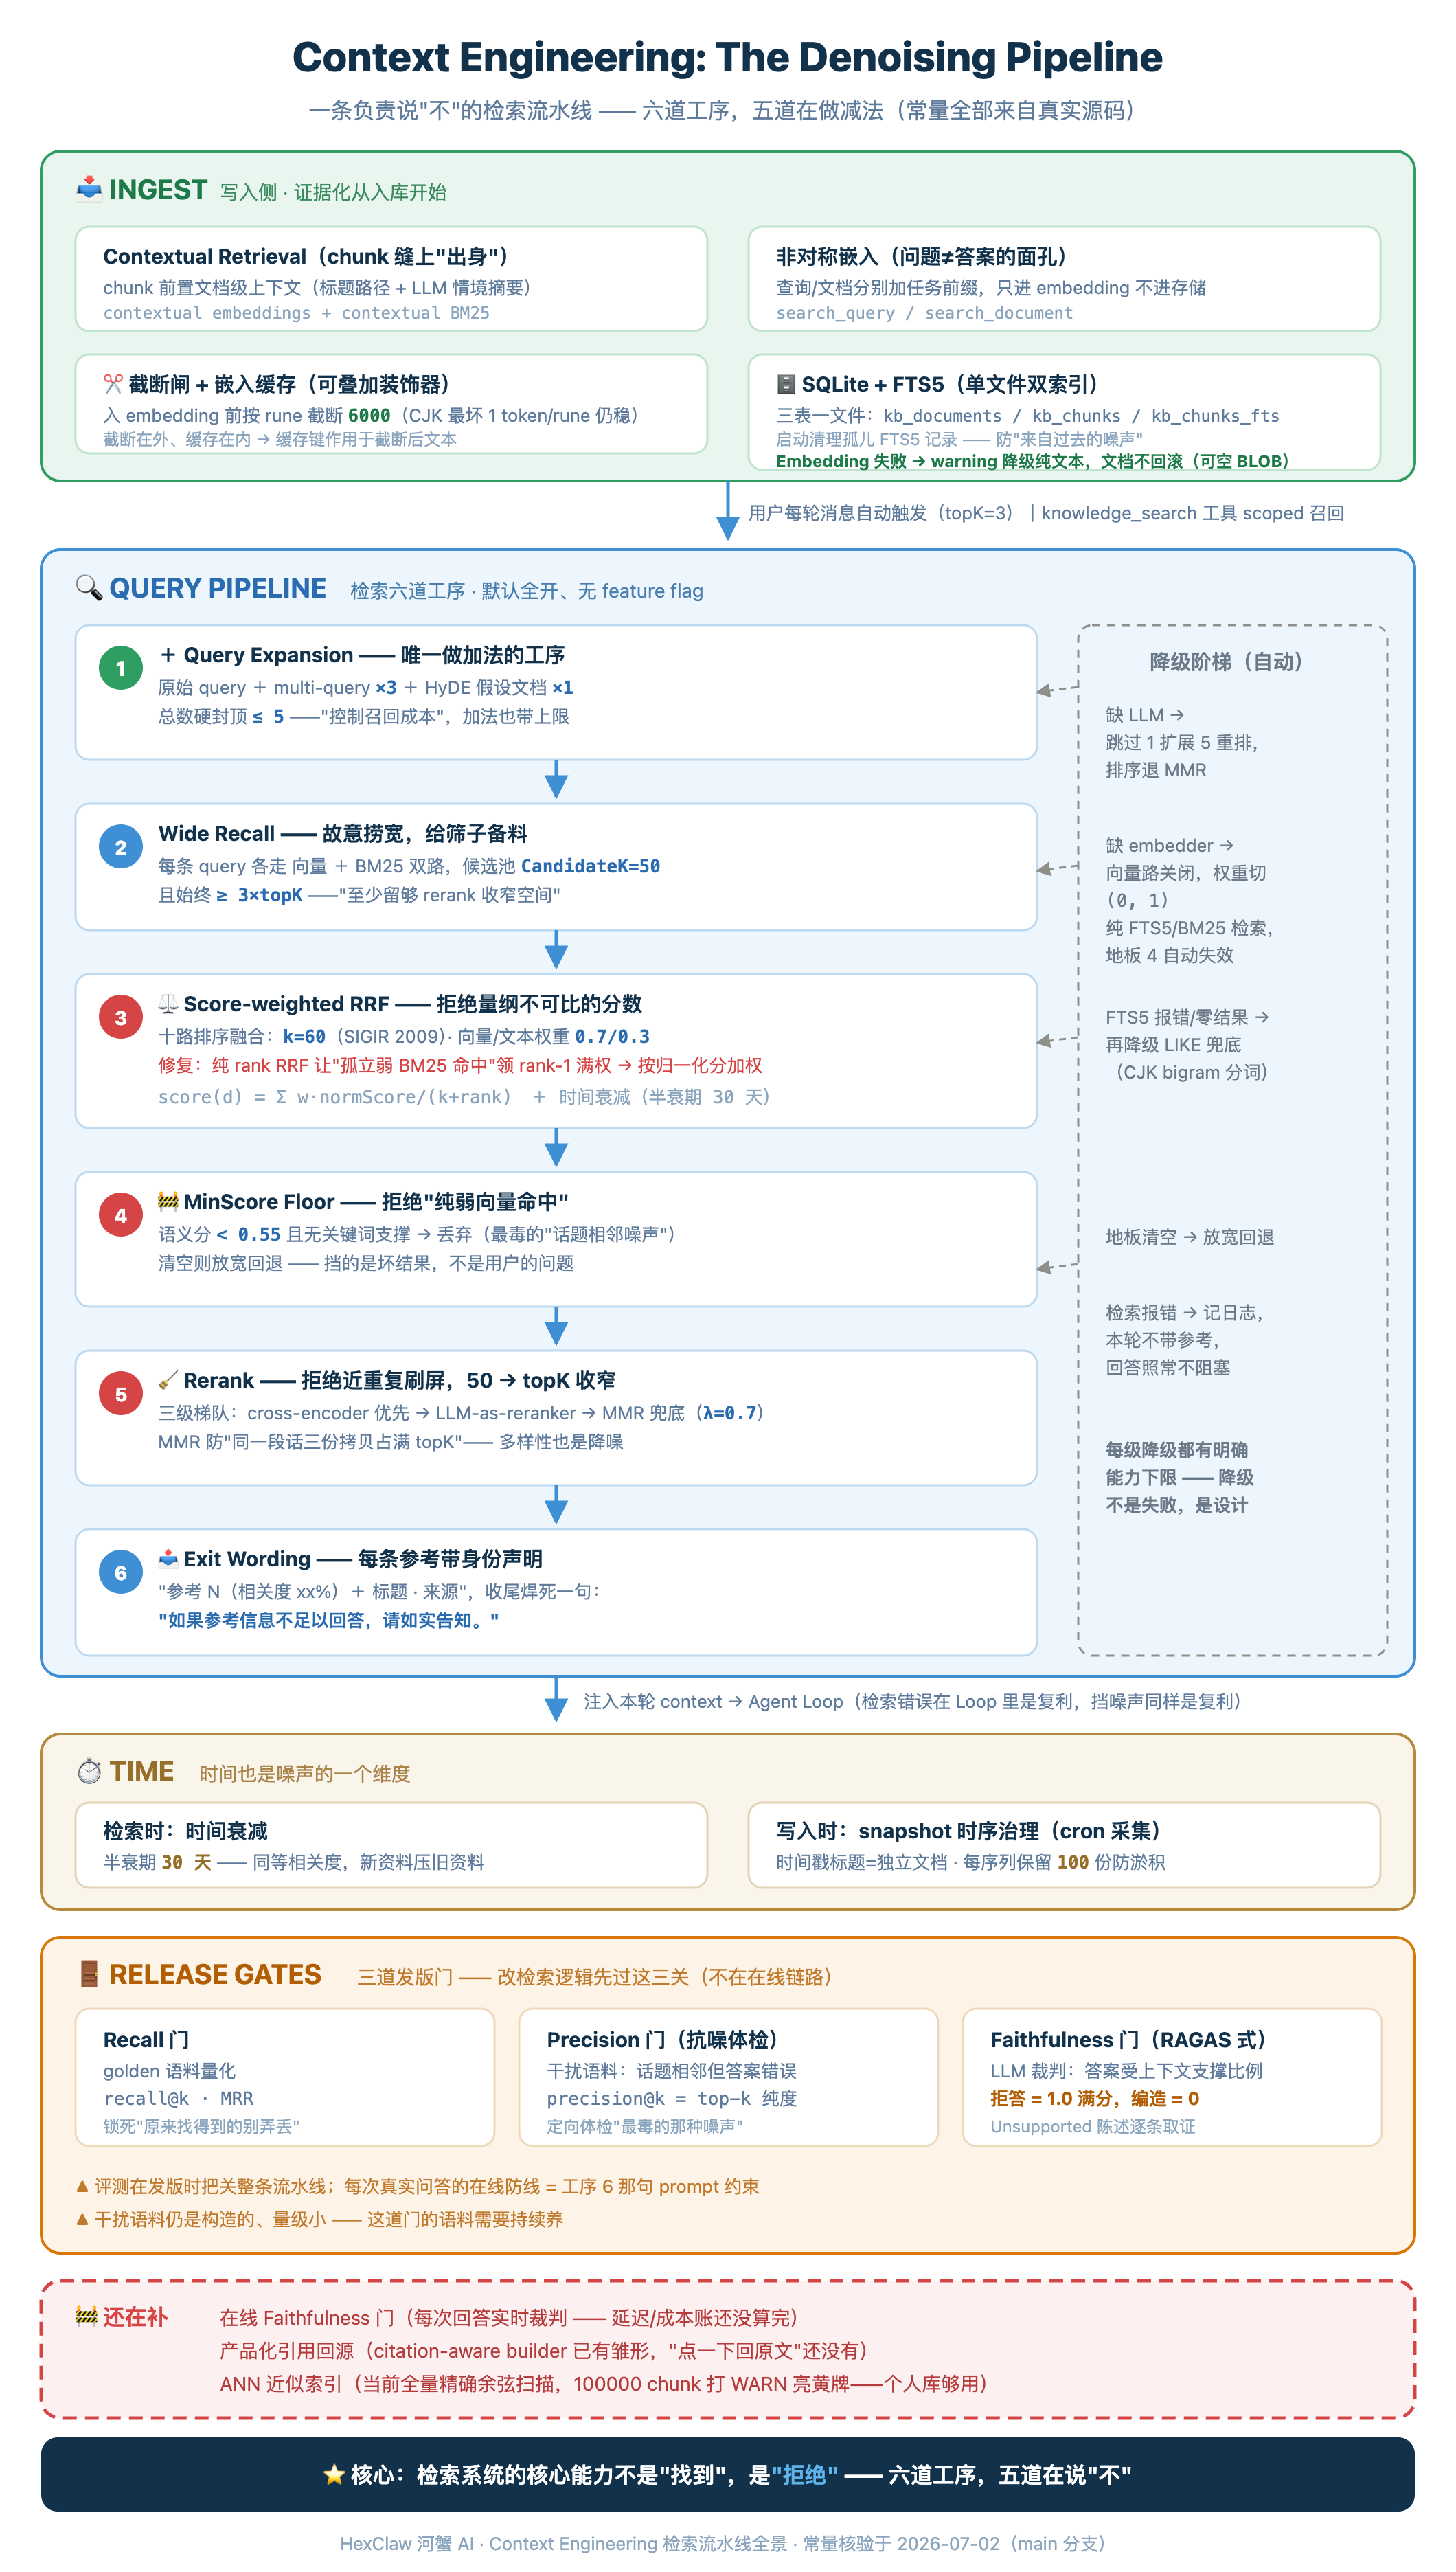
这条流水线装在哪:每一轮对话都在过闸
先把位置说清楚。河蟹引擎处理每一条用户消息时,有一个固定的步骤——源码注释里编号 5.5,"知识库检索(RAG 上下文增强)":只要知识库开着,就拿当前消息去 kb.Query() 走一遍完整检索,topK 默认 3,命中的内容作为 context 注入本轮对话。检索失败只记日志、绝不阻塞回答——资料层的故障不配打断对话,这是第一处"减法哲学":宁可这轮不带参考,也不让检索报错传染成回答报错。
除了这条每轮自动跑的路径,Agent 还有一个可以主动调用的工具 knowledge_search,源码注释把两者的分工写得很清楚:自动注入是"每轮对全库检索",工具调用是模型自己想要 scoped recall(限定范围的召回)时用的——按来源、按类型、按日期过滤,比如"只查我上传的 PDF""只看我上周存的东西",过滤条件直接下推到存储层。一条是背景辐射,一条是主动出击。
这个过滤的实现里还藏着一个能看出分寸感的细节:来源和类型条件是在 topK 之前就下推到存储层的——如果先取全库 topK 再过滤,真正匹配的文档可能根本排不进候选池,被静默漏掉。而日期这一维刻意没有下推:SQLite 里日期存的是 RFC3339 文本,跨时区的字符串字面比较不可靠,所以代码宁可退回 Go 层用真实的 time.Time 比——注释把理由写得明明白白。两种过滤,两种做法,各有各的原因,这种地方最能看出一套代码是抄来的还是想过的。
下面进流水线。它的完整顺序在源码注释里就是一行:查询扩展 → 宽召回 → RRF 融合 → 相关度地板 → LLM 重排——没有 feature flag 门控,默认配置就是全开,缺什么组件就自动降级什么环节。这个"默认即最佳实践"的选择后面还会再说。
工序零:入库时就开始防噪
很多人以为检索质量是查询时的事,其实一半在写入时就定了。先说资料怎么进门:上传入口吃常见格式,抽取统一下沉在后端做——PDF 用 poppler 的 pdftotext(ToUnicode 处理完整,专治中文乱码),老 .doc 走系统工具,图片直接交给视觉模型转写成可检索文本入库。最新的一步把这条入口修进了文档内部:PDF 扫描页、Word 里的内嵌图片——截图、图表、公式——会被逐张抽出来,交给视觉模型(VLM)转写成文字,以"文档视觉解析"小节并回正文一起入库。两个细节见功力:视觉转写复用知识库配置的同一个视觉模型,不在上传链路里另起模型调用路径(能力不分叉);没配视觉模型就诚实降级——只索引文本层,并明确警告"图片语义未入库",绝不静默。入口修得再宽,后面的纪律是同一套。
进门之后的第一刀是分块。chunk 最容易被当成"按字数一切"的体力活,但它其实是在定义证据的最小可引用单元:切太碎,模型拿不到前因后果;切太粗,向量相似度被无关内容稀释,捞回来的全是"里面好像有点相关"的大块头。河蟹的切法是结构优先、递归兜底——有标题层级的文档顺着结构切,纯文本或无标题的内容自动退化为递归切分;默认粒度 400 字、相邻块重叠 80 字,重叠是为了不把切口处的语义腰斩。对合同、专利这类天生结构化的文本,这一刀尤其值钱:条款、权利要求项本身就是天然的证据单元,顺着结构切,回答才能引用到"第几条",而不是"某一坨"。切口丢掉的全局语境,靠下面第一件事补回来。
切完块,管道还做了三件不显眼的事。
第一件:给每个 chunk 缝上"出身"。文档切块后,每个 chunk 会被前置一段文档级上下文——标题路径,加上可选的 LLM 情境摘要——然后向量 embedding 和 BM25 全文索引都建立在这段增强后的文本上。这就是 Anthropic 提出的 Contextual Retrieval(contextual embeddings + contextual BM25),他们的实测数字是:这一招把 top-20 检索失败率降了 49%,叠加重排后降 67%。它治的病很具体:一个孤零零的 chunk 写着"该配置默认为 30 天",没有上下文时你根本不知道它说的是哪个系统的哪个配置——缝上"出身"之后,无论走语义还是走词法,它都能被正确的问题找到、也更难被错误的问题误捞。顺带一提,给 chunk 写情境摘要的 LLM 调用本身也有预算:文档正文最多喂 6000 rune、单个 chunk 上限 1200 rune、单文档只给前 200 个 chunk 生成情境,超出打 WARN 不静默——增强手段自己先被管住了成本。
第二件:查询和文档不用同一副面孔进向量空间。对支持任务前缀的 embedding 模型(比如 nomic 系的 search_query / search_document),查询侧和文档侧分别加不同指令前缀——问题和答案在语义空间里本来就不该长一样,非对称嵌入让"提问找答案"这个方向对得更准。前缀只作用于 embedding 输入,不污染存储内容和 BM25。
第三件:在 embedding API 门口设一道截断闸。任何文本进 embedding 前按 rune 截断到 6000——这个数取得很实在:对 CJK 最坏情况(约 1 token/rune)也稳在主流 embedding 模型的 8191/8192 token 上限之内。正常的 400 字 chunk 根本碰不到它,它防的是超长 query、HyDE 生成的假设文档、或者误传整篇大文这类意外,避免一次 413 报错或一笔超量计费。截断器和 embedding 缓存是两层可叠加的装饰器,推荐截断在外、缓存在内——让缓存键作用于截断后的文本,同一篇长文的重复入库不会因为截断时机不同而缓存失效。这种两个装饰器叠放顺序都要掰扯清楚的地方,才是工程和 demo 的分界线。
存储底座是 SQLite + FTS5 虚拟表——没有引入独立向量数据库,向量和全文索引都落在同一个本机文件里。启动时还会清理一遍孤儿 FTS5 记录(chunk 已删但索引残留),防止已删除的资料阴魂不散地出现在检索结果里——这也是在防噪,防的是"来自过去的噪声"。
工序一、二:唯一做加法的环节,也带着上限
整条流水线只有第一道工序在做加法:查询扩展。用户的原始问题往往太短、太口语,直接拿去检索会漏。河蟹的做法是三路并发:原始 query 保留,multi-query 生成 3 个语义变体,HyDE(先让 LLM 写一段"假设答案"再拿它去搜——问题和答案在向量空间里不同形,但假设答案和真答案同形)再补一路。总数硬封顶 5 条,源码注释只给了六个字的理由:"控制召回成本"。做加法的环节也带着上限,这个克制是贯穿全链路的。
然后是宽召回:每条 query 各走一路向量搜索、一路 BM25 全文搜索,候选池 CandidateK = 50,且始终保证至少是最终 topK 的 3 倍——注释原话是"至少留够 rerank 收窄空间"。这是经典的 over-retrieve 设计:先故意捞宽,后面每一道减法才有得减。
工序三:融合——以及它修过的一个真实的坑
现在手里有最多十路排序列表(5 条 query × 向量/文本两路),每路的分数量纲完全不可比:余弦相似度是一个连续的几何量,BM25 是词频统计量,把它们直接加权求和,等于拿体温和气压做加法。业界的标准解法是 RRF(Reciprocal Rank Fusion,Cormack 等人 SIGIR 2009):不信分数、只信排名,每路贡献 1/(k+rank),k 取业界标准的 60。这个常数和论文出处,就写在配置字段的注释里。
但河蟹用的不是教科书版 RRF,而是分数加权 RRF——因为教科书版在真实使用里摔过一跤。这个坑值得完整讲:纯 rank RRF 只看排名不看分数,于是"某一路里孤零零的一个弱命中"会以 rank-1 的身份领到满额权重。什么时候会出现这种孤立弱命中?跨语种查询——你用中文问,文档是英文的,词法几乎零重叠,BM25 那一路可能只匹配到一个碰巧同形的词,分数低得可怜,但它是那一路的第一名。纯 RRF 会让这个虚假的词法命中,压过向量那一路真正的强语义命中。修复方式是给 rank 贡献乘上该路的归一化分数:
(fuse 核心逻辑,为排版略有精简;注释是源码原文)
效果是双向的:弱命中(归一化分低)的 rank 红利被同比缩小,而真正的精确命中——比如你搜一个函数名,BM25 给出接近满分——仍然保留满权。注释里的收尾写得很准:"既根治虚假命中带偏,又不损失精确术语匹配能力。"融合完的分数还要过一道时间衰减(半衰期 30 天):同等相关度下,新资料压旧资料。
工序四、五、六:地板、重排与出口——三道明着说"不"的闸
融合之后是整条流水线态度最鲜明的一道闸:相关度地板。向量相似度低于 0.55(作用在归一化到 0~1 的余弦分上)、且没有任何关键词命中支撑的候选,直接丢弃。注释里给这类候选起的名字叫"纯弱向量命中"——语义模型觉得"好像有点像"、词法上又完全没证据的东西,正是 The Power of Noise 里说的那种最毒的干扰项。它的判定逻辑短到可以整段贴出来:
注意第 8-10 行:如果地板把候选全干掉了,就放宽回退、原样返回。说"不"也有说"不"的边界——地板挡的是混在好结果里的坏结果,不是用户的整个问题。宁可少而准,但不能一个不剩。
过完地板,候选按融合分排序、限进 50 个的重排池,进入最后一道排序闸。这里有个三级梯队:专用 cross-encoder 重排器优先(更快、更省、更准),没有就用 LLM-as-reranker 复用聊天模型逐条判相关度,连 LLM 都没有,就回退到 MMR 多样性选取(λ=0.7)。MMR 兜底不是随便选的——它防的是另一种噪声形态:近重复的 chunk 把 topK 全部占满。同一段话被三篇文档各存了一份,相关度都高,全选进去等于 context 白白烧了三倍 token 还只有一份信息量。多样性本身也是降噪。
最后一道工序(第六道)是出口的措辞。检索结果不是裸文本拼进 context 的,每一条都带着身份声明——"参考 N(相关度:xx%)+ 文档标题 · 来源",而整段注入的收尾焊死了一句话:
"请基于以上参考信息回答用户的问题。如果参考信息不足以回答,请如实告知。"
这句是整条流水线在在线链路上的最后一道防线——前面五道工序都在筛"喂什么",这一句管的是"喂完之后怎么答"。它是 prompt 级的约束,强度有限,这个我们到发版门那节再算总账。
降级不是失败,是设计的一部分
这套降级哲学有一个具体的起点。补知识库这条线时,最早撞上的不是什么复杂算法,而是一行报错:
表面看是 Ollama 少拉了个 embedding 模型,拉一下就过去了。但它逼出来一个系统边界问题:一个知识库,凭什么因为 Embedding 模型没装,就连文档都不让你放进去?如果资料入库的第一道门是"向量化必须成功",这套系统就还不是知识库,只是个向量检索 demo。
所以降级阶梯的第一级砌在写入侧:原文先落库、chunk 先写入、FTS5 文本索引先可用——embedding 字段是可空 BLOB,配了模型就补向量,失败只打 warning、降级成纯文本索引,文档绝不回滚。(doc_id, chunk_index) 的唯一约束还顺手防住了重建索引时同一位置的 chunk 越堆越多。一句话:Embedding 是增强索引,不是文档本体。
查询侧的阶梯接在后面:
▸ 缺 LLM(比如只配了 embedding、没配聊天模型):查询扩展和 LLM 重排自动跳过,排序退到 MMR——链路仍然完整,只是少了两道增强。
▸ 缺 embedder(一个模型都没配):向量路整个关闭,权重自动切成纯文本(0/1),整条链退化为 FTS5 + BM25 的纯关键词检索,相关度地板也随之自动失效(它本来就是给向量分设的)。
▸ FTS5 失手:查询里带特殊字符报了错、或中文分词不匹配查出零结果,都再降一级到 LIKE 扫描兜底;分词侧另有 CJK bigram + 原词保留,让中文和代码符号都有词法着落。
▸ 地板清空:放宽回退,不清空结果。
▸ 检索报错:记日志,本轮不带参考,回答照常。
每一级降级都有明确的能力下限,且全部是自动的、无感的。这和"默认即最佳实践、无 feature flag"是同一个设计立场:检索质量不该是一个需要用户研究配置文档才能获得的东西,也不该因为少配了一个模型就整体罢工。本地部署的软件面对的环境千奇百怪,降级阶梯就是它的适应性。
同一种诚实也体现在容量上。河蟹没有引入独立向量库,向量检索是 Go 层对 embedding BLOB 的全量精确余弦扫描:逐行解码、算完就丢,向量不常驻内存;每扫 1000 行检查一次取消信号,长扫描随时可以中断;超过 100000 个 chunk 就打 WARN——不静默,明着告诉你该考虑近似索引了。
这个取舍的立场很清楚:个人知识库的量级下,精确扫描比近似检索更稳,不为过早的性能优化牺牲召回。真到要横向扩展的那天,正确的演进也不是把阈值调大,而是把索引层整个抽出去换 ANN(HNSW、DiskANN 一类近似索引)——前提是 source / doc / chunk 这些证据字段的语义原样保留。O(n·d) 是它的真实边界,十万是它自己亮出来的黄牌。
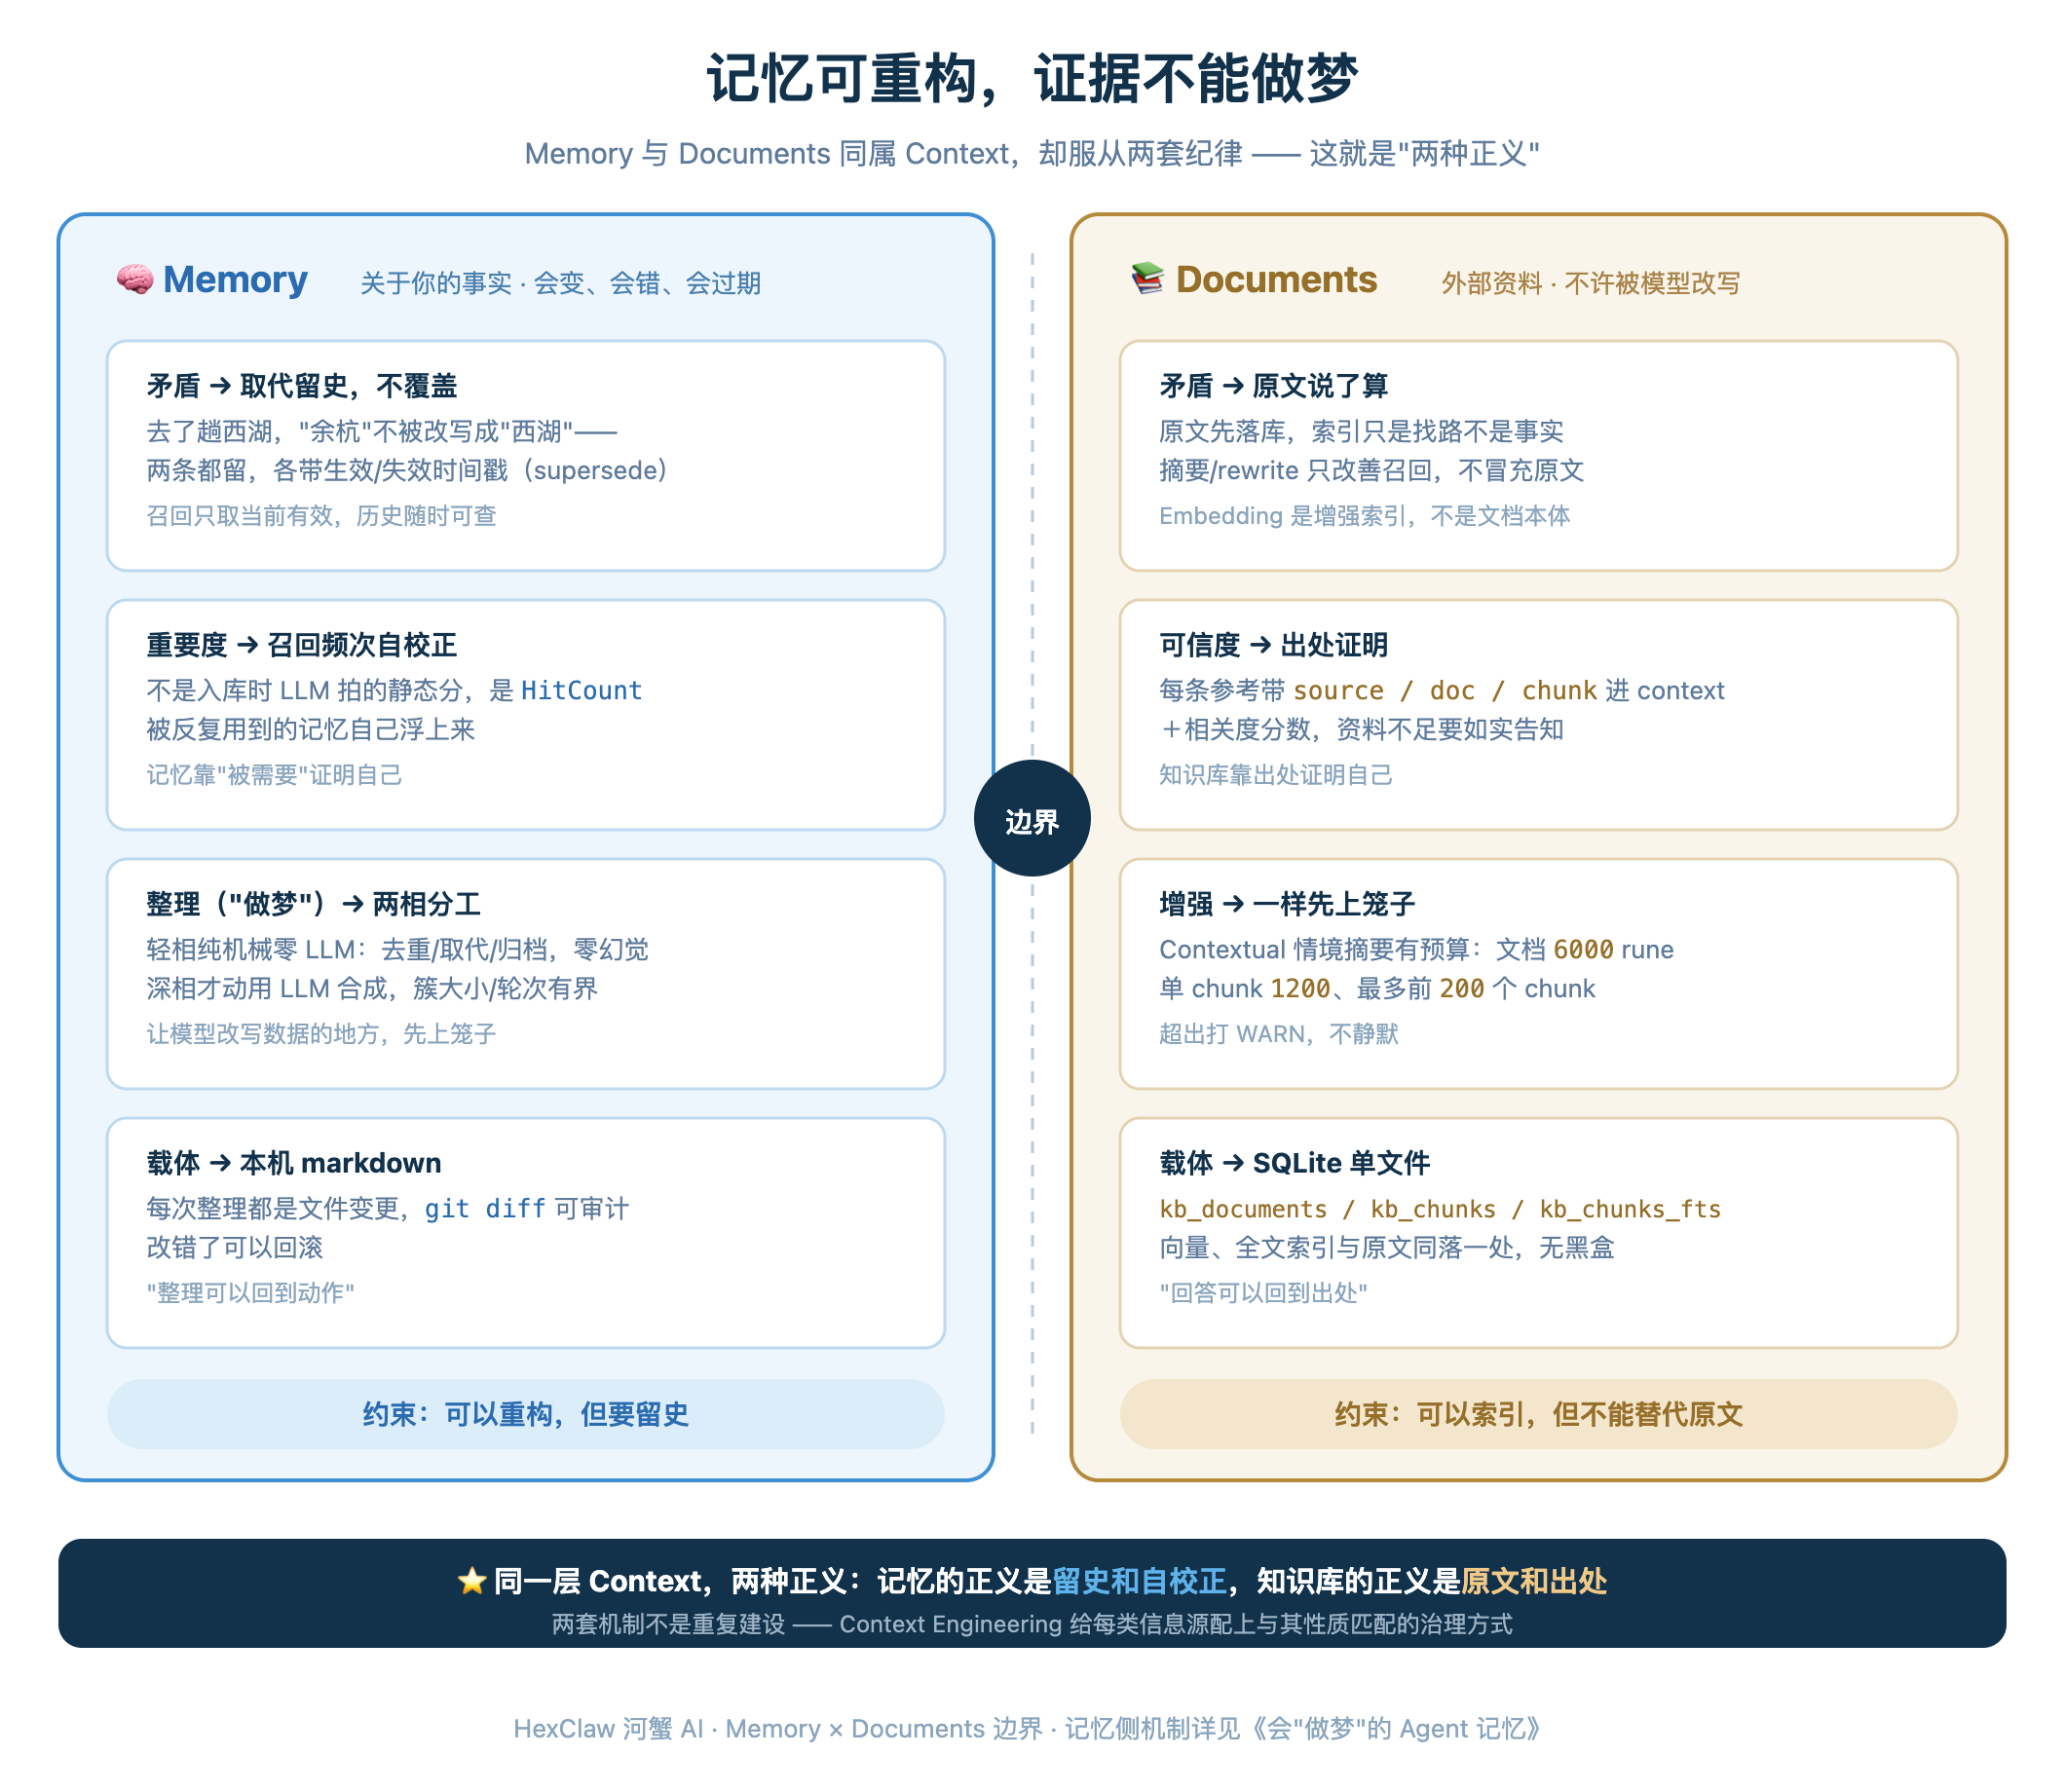
Memory 也是 Context:两套检索,两种正义
有个问题绕不开:河蟹的记忆系统也是 context 的来源,为什么记忆召回和知识库检索是两套完全不同的机制?记忆那边是 0.7 向量 + 0.3 BM25 的加权和,再乘上新近度和重要度;知识库这边是 RRF 融合加 LLM 重排。不是谁先进谁落后——是两类数据的正义标准不同。
记忆是"关于你的少量高价值事实",几百条的量级,召回讲究的是"你上周说过的事优先于三个月前的"——时间和重要度是一等公民。知识库是"大量文档里找证据",几万个 chunk 的量级,讲究的是在十路异构排序里融合出真正相关的那三条——抗噪是一等公民。用一套机制通吃两类数据,才是真正的偷懒。这也是 Context Engineering 作为一层的意义:它不是一个检索算法,是给每类信息源配上与其性质匹配的治理方式。
记忆那一支的纪律,上上篇整篇拆过,这里只把最能说明"两种正义"的四个设计摆出来对照:
▸ 矛盾不覆盖,取代留史。你常在余杭区,去了趟西湖区随口说一声——"当前在哪"是个只能有一个值的事实,余杭区和西湖区在这条上就是矛盾。多数记忆系统会把"余杭区"那条直接改写成"西湖区",河蟹不改写:两条都留着,各带生效/失效时间戳(supersede),召回只取当前有效的,回了余杭区再自动切回来,历史随时可查。知识库的原文不许改,记忆的历史不许丢,是同一种严谨在两类数据上的不同长相。
▸ 重要度会自校正。一条记忆重不重要,不是入库时让 LLM 拍一个静态分,而是看它被召回命中的频次(HitCount)——被反复用到的记忆自己浮上来。知识库靠出处证明自己,记忆靠"被需要"证明自己。
▸ 整理("做梦")分两相。轻相纯机械零 LLM:去重、取代、晋升降级、归档,不可能产生幻觉;深相才动用 LLM 做合成,而且簇大小和每轮簇数都有界。和知识库"给 Contextual 摘要设预算"是同一个手笔:凡是让模型改写数据的地方,都先上笼子。
▸ 全部落在本机 markdown,能 git diff。记忆的每一次整理动作都是文件变更——可审计、可回滚。这是知识库那句"回答可以回到出处"在记忆侧的镜像:整理可以回到动作。
这四个设计对应的都是记忆这类数据的天性:关于你的事实会变、会错、会过期,所以记忆的"正义"是留史和自校正;文档不许被模型改写,所以知识库的"正义"是原文和出处。两套机制不是重复建设,是 Context Engineering 在两类信息源上各自兑现了同一句话——凭什么信。
知识库自己的时间维度也有专门治理。除了检索时 30 天半衰期的时间衰减,还有一个容易被忽视的入口:定时任务每天往知识库里写采集结果——热搜榜、仓库星标数、价格监控。这类数据的本质是时间序列,不是单篇文档:今天的热搜不该覆盖昨天的,昨天的也不该永远赖着不走。河蟹的处理是给每次采集的文档标题带上时间戳,让每一轮成为独立文档(自然支持"上周三的热搜是什么"这种带时间的检索),同时每个序列默认只保留最近 100 份快照,防止一个每小时跑一次的任务把知识库淤成沼泽。采集进来的是资料,治理完才是证据。
三道发版门——以及哪些还没进在线链路
上面说的都是在线链路:每次问答真实跑的代码。但"这条流水线到底好不好",靠感觉是不算数的。知识库源码里还有三套评测护栏,它们不在在线链路里,跑在发版门上——改了检索逻辑,先过这三关:
第一道:recall 门。固定的 golden 语料 + 查询集,量化 recall@k 和 MRR,指标计算完全确定性。它锁死的是底线:"这次改动有没有把原来找得到的东西弄丢"。
第二道:precision 门。这道门直接对着本文的主题来。源码注释先给行业挑了个刺:"既有评测重 recall(相关文档在不在 top-k),轻 precision(top-k 里混进了多少不相关的近义干扰文档)。"所以它专门构造了一套干扰语料:每个查询配上真正相关的文档,再故意混入话题相邻但答案错误的干扰文档——节日与假期同域、关系型数据库与缓存和消息队列同域——然后量 precision@k:top-k 的纯度有多高,干扰泄漏了多少。这正是 The Power of Noise 那类"最毒噪声"的定向体检。
第三道:忠实度门。对齐 RAGAS 框架,用一个强模型当裁判,对(问题,检索上下文,生成答案)三元组打三个分:Faithfulness(答案里的事实陈述有多大比例能在检索上下文中找到支撑)、AnswerRelevance(是否切题)、ContextRelevance(上下文本身是否相关),还会把裁判认定"上下文未支撑"的陈述逐条列出来当编造嫌疑取证。这套评分里藏着全文我最喜欢的一个设计:
答案若是拒绝回答、说明资料不足而未陈述任何事实——Faithfulness 记 1.0,满分。
在这套评分体系里,"承认不知道"不是失败,是忠实的最高形态。编造才是零分。
该把丑话说完了。首先,这三道门是发版门,不是在线门——每次真实问答的链路里,没有人对"这次的答案"跑忠实度裁判,在线链路的最后防线就是那句"资料不足请如实告知"的 prompt 约束。把裁判搬进在线链路,意味着每次回答多一笔延迟和成本,这笔账还没算完,所以还没做。
其次,出处止步于 context。参考的标题和来源确实喂给了模型,但"答案里这句话引自参考几"的产品化回源——点一下句子跳回原文那种——还没有。检索管道的门面里躺着一个 citation-aware context builder 的雏形,差的是最后一段产品化。换句话说,现在的出处是给模型看的,还不是给你核的。
最后,干扰语料还是构造的,量级也小。它挡得住"这次改动把抗噪能力改崩了"这类回归,但离"证明这条链路在你的真实语料上抗噪"还有距离。这道门的语料,得持续养。顺带把另一笔账也认了:文中 49%、67% 是 Anthropic 在他们语料上的数,河蟹这条链路还没有能对外引用的自测对比数字——空着不如认着。
账说完了,把这篇讲的所有取舍压成一张验收清单。不管你用不用河蟹,自己搭 RAG 时可以逐条对一遍:
□ 2 只存向量不存原文,等于同时放弃引用、重建索引和审计三件事。
□ 3 给 (doc_id, chunk_index) 加唯一约束,重复入库和重建索引才不会堆出重影。
□ 4 过滤要在 topK 之前生效,否则真命中被静默挤出候选池。
□ 5 BM25 和向量分数量纲不可比,别直接相加——先归一,或走 RRF。
□ 6 相关度地板只砍"纯弱向量命中",别误杀关键词命中;砍空了要放宽回退。
□ 7 重排兜底至少留一层 MMR,防近重复 chunk 占满 topK。
□ 8 评测别只量 recall——top-k 里混进了多少"话题相邻的干扰",要有专门的语料去量它。
回到 Loop:把选择权交给一条可审计的流水线
上一篇说,四代范式是一场控制面外推,每往外推一层,你就交出一层决策权——Context 这一层交出去的是信息选择权:模型每一轮看到什么、看不到什么,不再由你逐条把关。
这篇写完,这句话可以补上后半句了:交出去可以,但要看交给了什么。交给"把全库塞进窗口"是认知上的偷懒,交给一条每道工序都有理由、有常量、有降级路径、有发版门看守的流水线,才叫工程。检索错误在 Loop 里是复利,反过来也成立——挡噪声的每一道闸,在 Loop 里同样是复利。
这条流水线里,哪些是抄业界的作业,哪些是自己的活,也分得清:Contextual Retrieval、RRF、HyDE、RAGAS 是站在公开实践的肩膀上;分数加权的 RRF 修复、CJK bigram 加 LIKE 的双层词法兜底、"拒答=满分"的评分设计、给定时采集做时序治理的 snapshot、以及记忆侧的取代留史和两相做梦——这些是这套系统自己踩坑踩出来的做法。工程的辨识度不在发明新范式,在每个取舍都能说出为什么。
四代范式还剩两层。下一篇写 Harness——查一下词典你会发现,这个词的本义就是给牛马套的马具,而这个系列恰好有一篇把 Agent 叫"赛博牛马"。这不是巧合,是下篇的题眼:聪明是模型给的,敢让它干活的底气是马具给的。先把这句放在这儿,下篇兑现。Prompt 篇压轴收官。
四代范式系列
▸ Loop · 纲领 扒开一个开源 Agent 的源码,从 Prompt 到 Loop 逐层对完这四代范式
▸ Context · 记忆侧 会"做梦"的 Agent 记忆:河蟹的梦在你本机
▸ Harness · 下篇 "赛博牛马"的聪明是模型给的,敢让它干活的底气是"马具"给的(在写了)
更多往期
▸ 河蟹 AI 的"赛博牛马"养成记:把一句话编译成会自愈的沙箱脚本
▸ 河蟹 AI 背后的 Claude Code SOP:设计驱动 × 测试闭环 × 多 Agent 协作
参考来源
· Andrej Karpathy,X(2025-06),"context engineering" 一词的公开背书
· Tobi Lütke,X(2025-06),关于 context engineering 的定义
· Anthropic,Effective context engineering for AI agents(2025-09)
· Anthropic,Introducing Contextual Retrieval(2024-09)
· Chroma Research,Context Rot: How Increasing Input Tokens Impacts LLM Performance(2025-07)
· Cormack, Clarke & Buettcher,Reciprocal Rank Fusion,SIGIR 2009
· Cuconasu et al.,The Power of Noise: Redefining Retrieval for RAG Systems,SIGIR 2024
· Liu et al.,Lost in the Middle: How Language Models Use Long Contexts,TACL 2024
· Gao et al.,Precise Zero-Shot Dense Retrieval without Relevance Labels(HyDE,2022)
· Es et al.,RAGAS: Automated Evaluation of Retrieval Augmented Generation(2023)
· 本文全部河蟹侧机制与常量核验于 2026-07-02,对应仓库 main 分支源码