AI 圈的关键词这些年一直在往外推:Prompt Engineering 打头,接着是 Context Engineering、Harness Engineering,而最新的 Loop Engineering 几乎是这阵子才冒出来的。听着像热词接力,可摆在一起看,其实是同一条线越推越远。每个词还都自带一句上头金句——Claude Code 的创造者、Anthropic 的 Boris Cherny 就在台上甩出这么一句:
"I don't prompt Claude anymore. I have loops running. They're the ones prompting Claude and figuring out what to do. My job is to write loops."
(我已经不给 Claude 写 prompt 了——是一堆 loop 在跑,由它们去 prompt Claude、自己琢磨下一步干嘛。我的活儿,就是写 loop。)
几乎前后脚,OpenClaw 创始人 Peter Steinberger 发了条被疯转的推文,更短:
"you shouldn't be prompting coding agents anymore. You should be designing loops that prompt your agents."
(别再给编码 Agent 写 prompt 了,去设计能替你 prompt Agent 的 loop。)
Google Cloud AI 总监 Addy Osmani 随后给这个现象起了名字——Loop Engineering。三个人前后没差几天,这词新得还没焐热。
而这套东西最纯粹的形态,其实 2025 年就有人写出来了——开发者 Geoffrey Huntley 的 Ralph 循环,核心只有一行 bash:
每一轮都开一个全新的上下文窗口,状态不靠对话历史、而靠文件系统和 git 传递。社区把它浓缩成一句话——Agent 会忘,仓库不会忘。这不只是口号:河蟹把记忆、技能、状态全落成你本机能 git diff 的纯文本,这是它整个设计的底色——后面每一层都会再撞见它。
这套说法一冒头,质疑声也跟着来——而且泼得有道理:这不就是把十几年前的 CI/CD 重新发明一遍吗?触发靠 cron/webhook,隔离靠"Worktree 沙箱"(说穿了就是个 Docker 容器),验证靠 ESLint/Jest,绿了通知、红了打回去重写——这套流程 Jenkins 时代就跑顺了,无非裹了层 AI 糖衣。说得一点没错。再往深一层,它的内核其实是更老的东西——控制论里的反馈回路:把 Loop 画出来,观测、对比、行动、重复,它和恒温器、PID 控制器、Kubernetes 的 Reconciliation Loop,是同一棵家谱树上的分支。也没错。
所以"是不是新瓶装旧酒"这个问题,我觉得吵不出结果,也不重要。真正值钱的问题是另一个:有没有哪个真系统,真把这一环闭上了?还是大家都只是在嘴上闭环?概念人人会画,PPT 上的箭头首尾相接很容易;难的是落到代码——谁来当那个独立裁判、loop 凭什么会停下来、"做完了"到底由谁、按什么标准判定。
这篇不复述理论(讲概念、讲类比的好文章已经够多了)。它做的是另一件事:把河蟹这个开源 Agent 的源码摊开,从 Prompt 到 Loop 四层一层层对完,每层都落到真实文件、真实常量、真实终止条件上——读完你拿到的不是几个新黑话,而是看得清一套生产级 loop 到底由哪些零件咬合而成、每个零件为什么是现在这个值。哪层做透了讲透,哪层只做了一半,就老老实实标"这层我还在补"——尤其是 Loop 层,那里既有让我自己都意外的真闭环,也有整个行业都还没跨过去的那道坎。
本文核心判断
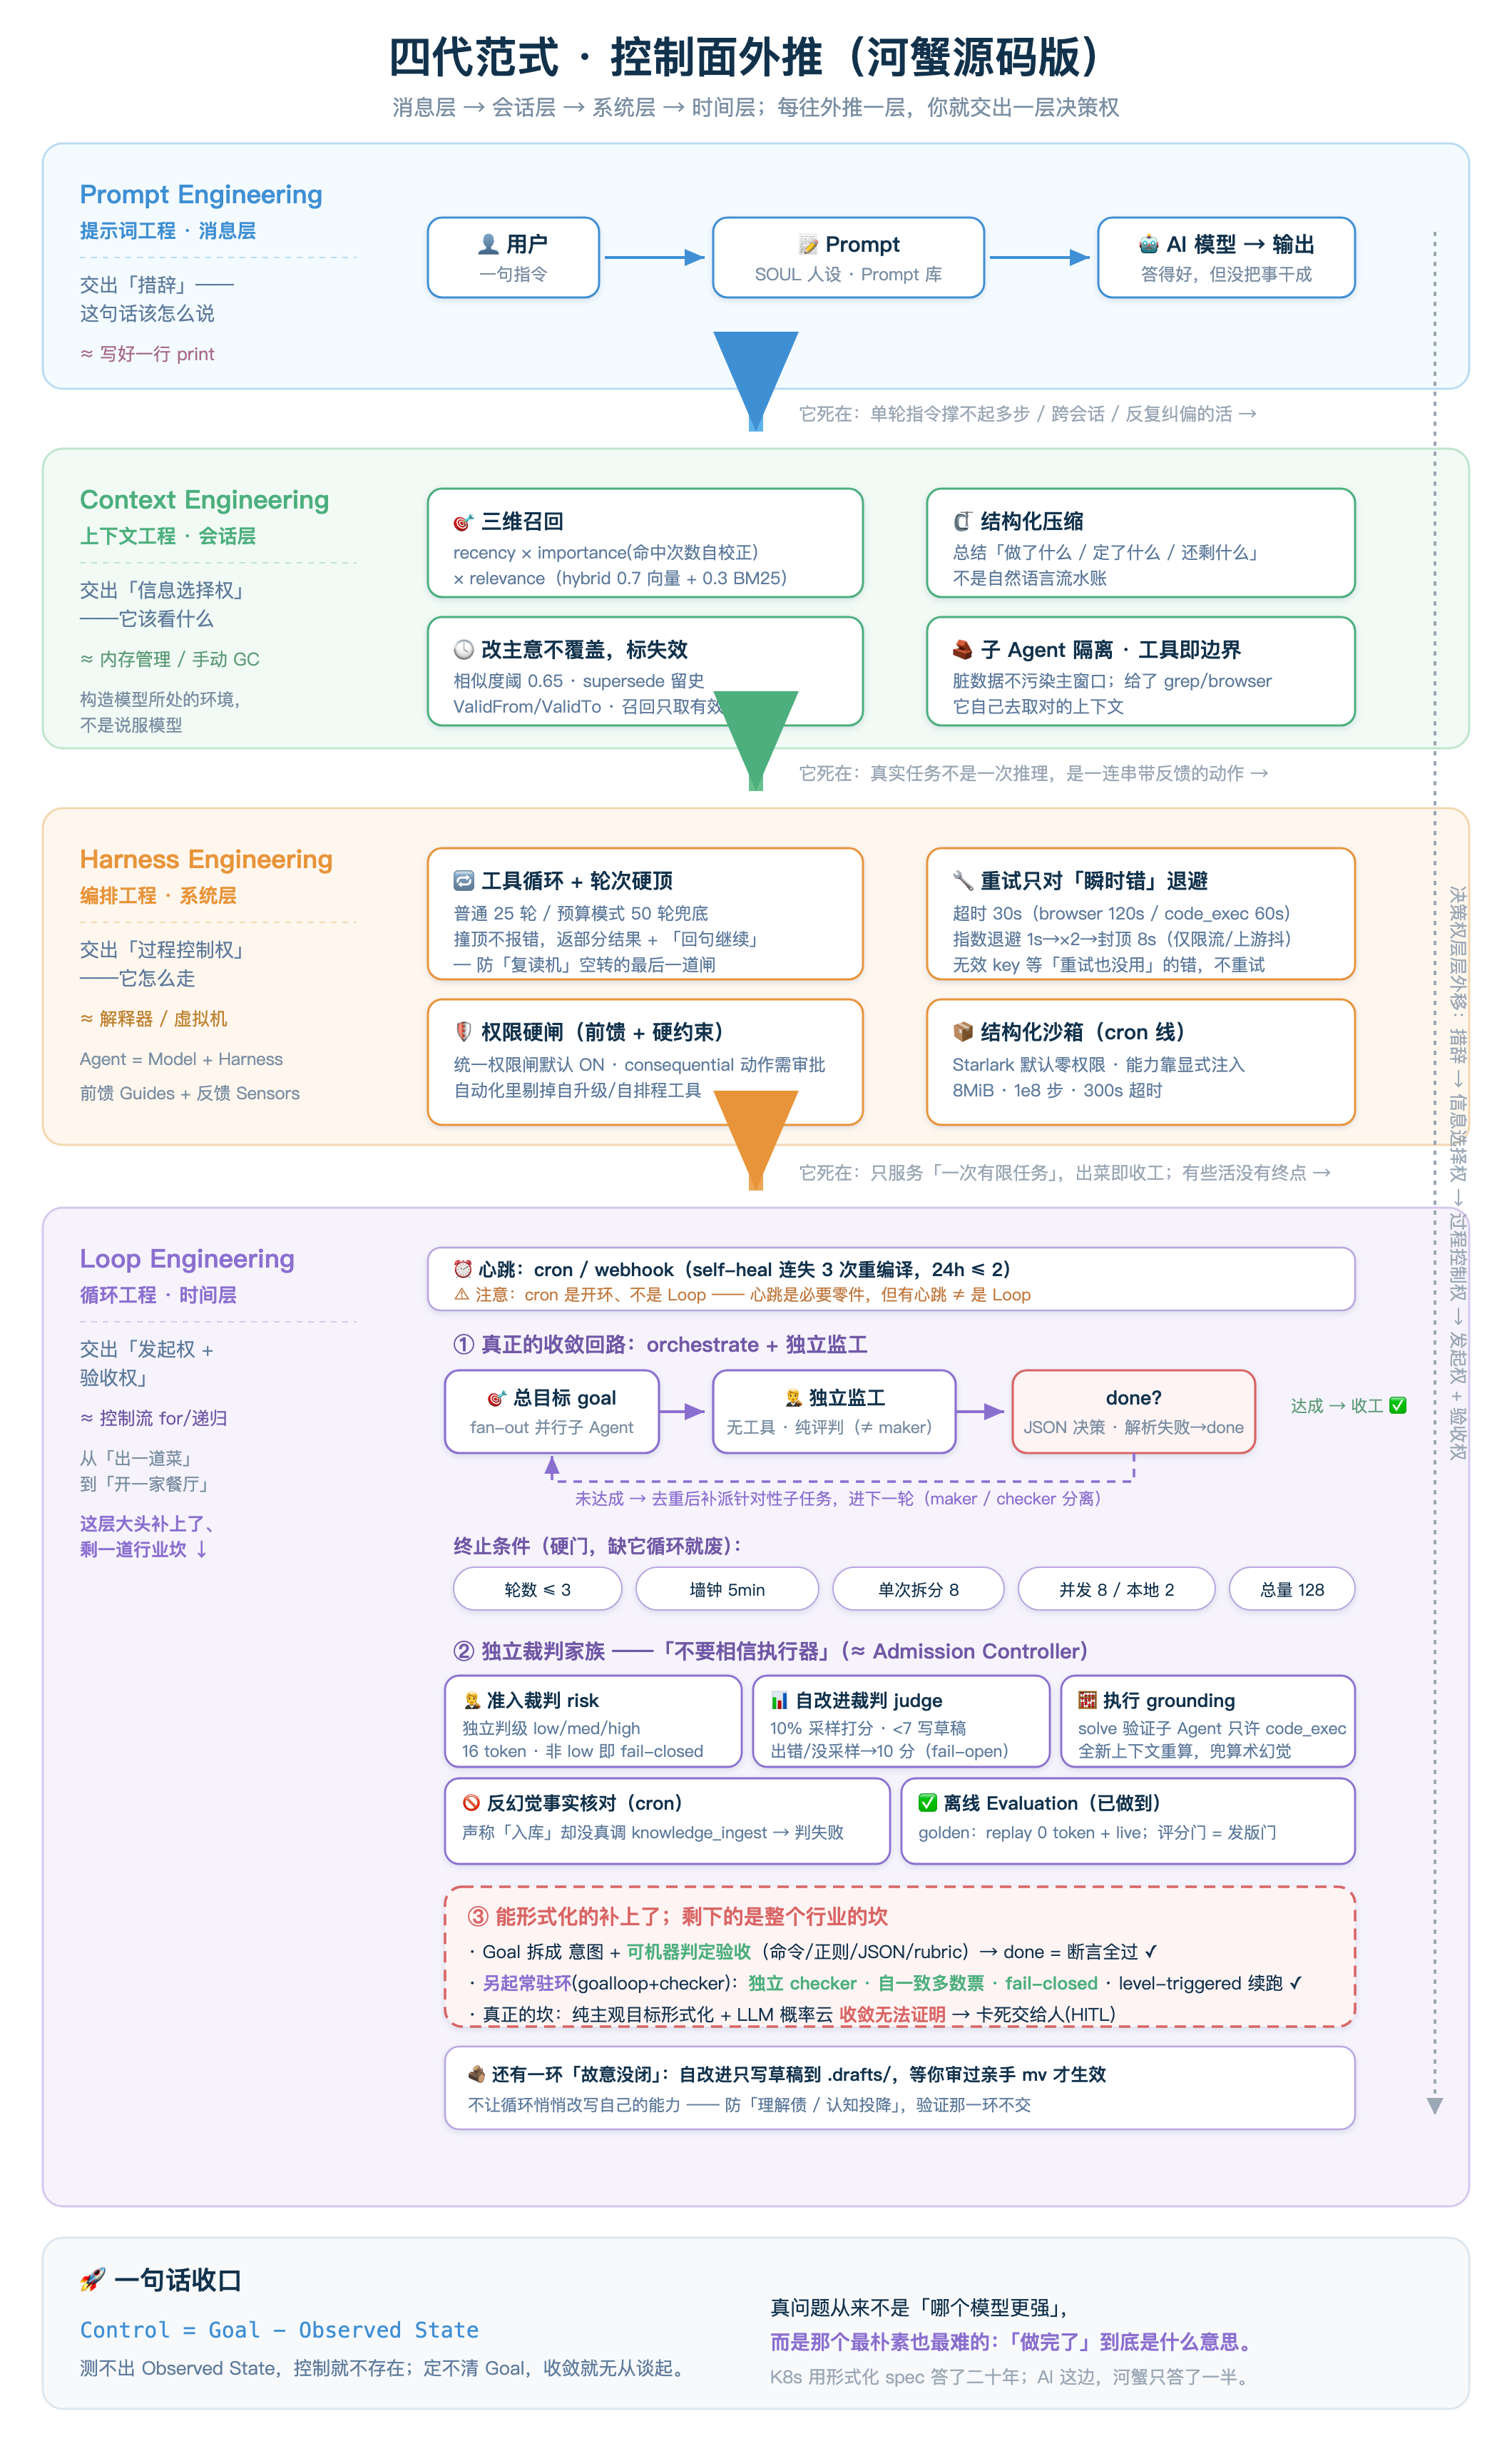
这四代范式不是互相替代,是层层叠加——而贯穿它们的那条隐线是:每往外推一层,你就把一层决策权交出去(措辞 → 信息选择权 → 过程控制权 → 发起权和验收权)。
河蟹这四层都有真代码可看。但真正的天花板不在前三层,而在第四层里最难的那两件事——"目标"怎么形式化、"做完了"怎么量化。这两件,河蟹和整个行业一样,都还在补。
(下图是河蟹源码版的"控制面外推"——四层各填了真实组件与常量,Loop 层画出了真实的收敛回路与那道还没跨过的坎)
第一层 · Prompt(消息层):你交出的是"措辞"
最早大家信的是:Prompt 是 AI 时代最重要的技能。System prompt 怎么写、few-shot 怎么摆、思维链怎么引——一句指令打磨到极致。用计算机的话说,这一层对应的就是写好单条语句,相当于斟酌一行 print 怎么措辞。你交出去的,是"这句话该怎么说"。
河蟹在这层有该有的东西:可编辑的助理人设(SOUL)、system prompt 管理、能存起来随手复用的 Prompt 库。但这层我不打算多写,因为它很快就撞墙了:模型越强,Prompt 的边际收益越低;更要命的是,单轮指令撑不起一件需要多步、跨会话、反复纠偏才能办成的活。你把一句话说得再漂亮,模型也只是"答得好",不是"把事干成了"。于是关注点必须往外推一层——别光盯着这一句话,去管模型周围那一圈环境。
第二层 · Context(会话层):你交出的是"信息选择权"
第二代的认知升级很关键:问题不再是"如何说服模型",而是"如何构造模型所处的环境"。上下文窗口是稀缺资源——往里塞什么、不塞什么、按什么顺序塞,决定了模型的判断路径。用计算机的话说,这一层是内存管理和手动 GC:窗口就是 RAM,你得手动决定淘汰谁、压缩谁。你交出去的,是"该看什么信息"的选择权——你划定信息范围,模型在范围内自己发挥。
河蟹在这层是有底气的,而且大多有真实常量可核:
- 三维召回——记忆不是简单按时间倒序,而是 recency(新近度)× importance(重要度,用召回命中次数自校正,越被想起越重要,而不是 LLM 拍一个静态分)× relevance(相关度,hybrid 0.7 向量 + 0.3 BM25;没配向量化器就软降级成纯 BM25)。
- 改主意不覆盖、而是标失效——抽取去重的相似度阈是 0.65;遇到矛盾走 supersede 留史(记 ValidFrom / ValidTo,召回只取当前有效的那条),旧版本留着可回溯,而不是抹掉。
- 结构化压缩,不是流水账摘要——历史长了不是简单截断或自然语言复述,而是结构化地总结成"做了什么、定了什么、还剩什么",再用压缩版替换原始历史(这点和业界主流的做法是一致的)。读超长日志 / 外部文档时,开一个子 Agent 隔离去读、只把摘要喂回主窗口,避免脏数据污染主线。
- 工具即上下文边界——给 Agent 配了
grep/browser,它就能自己去把对的上下文取回来。你通过控制工具,间接控制它能触达的信息边界。
(记忆这套——三层结构、三维召回、半衰期、还会"做梦"半夜整理画像——我上一篇专门拆过,这里只点到为止:会"做梦"的 Agent 记忆。)
但这层做到位了,新问题又冒出来了——这也是第三代的导火索:即使上下文给全了,Agent 跑长任务还是会翻车。因为真实任务的本质从来不是"一次推理",而是"一连串带反馈的动作"。模型一旦连续干很多步,它自己能力的短板就藏不住了:会陷进"复读机"(反复用同一招、空烧 token)、会越权干危险操作、会半路崩掉。光给它信息不够,得给它立规矩、上护栏。
第三层 · Harness(系统层):你交出的是"过程控制权"
Harness 这个词,最贴切的翻译其实是 Mitchell Hashimoto 那句话:Agent = Model + Harness。模型是发动机,Harness 是套在它外面的整个运行时——工具管道、I/O、安全壳。用计算机的话说,这一层就是 Agent 的解释器 / 虚拟机。Thoughtworks 的 Martin Fowler 和 Birgitta Böckeler 用控制论术语把它拆成两半,特别清楚:Guides(前馈控制)在 Agent 动手之前引导它——规范、Skill、硬约束,提前告诉它什么不能做;Sensors(反馈控制)在 Agent 动手之后观测纠偏——测试结果、类型检查、裁判,把偏差喂回下一轮。你在这层交出去的,是单次运行内的过程控制权:调哪个工具、走哪条路、什么时候该压缩历史——它自己定;但任务从哪开始、安全边界划在哪,还在你手里。
这套"动手前引导、动手后纠偏"的结构不是凭空冒出来的,学术上有条清楚的谱系:Agent 一步步"想一下 → 调个工具 → 看结果 → 再想"的交替循环,最早被 ReAct(Yao et al., ICLR 2023)形式化成 Thought–Action–Observation 三拍——河蟹那个"始终把工具列表递给模型、它要调就执行再接着转"的工具循环,本质就是 ReAct 的工程实现。而 Harness 真正在干的,说穿了不是把模型变聪明,而是替它把要搜索的空间压小:一个 T 步的任务、每步有 N 个候选动作,朴素地走路径数是 NT 的指数爆炸;前馈约束一上——这十类操作禁止、那五步流程必走——每步的有效分支因子就从 N 砍到很小,指数的底数随之塌下来。用信息论的话讲是 H(行动│规则) ≪ H(行动):给定规则后,下一步的不确定性大幅降低。这不是空谈——LangChain 做过一个很干净的对照实验:底层模型一字不改(固定 gpt-5.2-codex),只把外面那层 Harness 换得更精巧,TerminalBench 2.0(让 Agent 在真实终端里跑任务的评测)通过率就从 52.8% 抬到 66.5%、排名从 Top 30 冲进 Top 5。"同一个模型、换个壳就更强"最不玄的解释就在这儿:不是它涨了智商,是你提前替它削掉了大半的试错熵。
河蟹这层的料,挑几样有真实常量的说:
- 工具循环 + 轮次硬顶——这是 Harness 的心脏:始终把工具列表传给模型,模型要调工具就执行、然后接着循环,直到它给出最终答案。普通模式下轮次上限 25,开了预算控制则放到绝对安全上限 50。这个"硬顶"就是防"复读机"空转的最后一道闸——撞顶不算报错,而是带回模型已产出的部分结果 + 一句"已到轮次上限,回句'继续'我接着干",优雅降级。
- 工具重试只对"瞬时错"退避——默认工具超时 30s(
browser放到 120s、code_exec60s)。重试是指数退避(1s 起,×2,封顶 8s),但只对明确的瞬时错误(限流、上游抖动)退避重试;无效 key、模型不存在这类"重试也没用"的错,绝不盲目重试浪费时间。 - 权限硬闸(前馈 + 硬约束)——把危险动作的拦截从 prompt 里的"软约束"提到代码层的"硬约束"。统一权限闸默认开着,consequential 的动作命中"需审批";无交互的自动化会话里(cron/webhook),还会剔掉自升级、自排程这类工具,挡住"loop 自己给自己加权"的失控路径。
- 结构化沙箱——cron 那条线把一句话编译成 Starlark 脚本,跑在一个默认零权限、只有显式注入能力的沙箱里(8MiB 内存 / 1 亿步 / 300s 超时)。这是能力安全模型,我在 cron 那篇拆透过:「赛博牛马」养成记。
这层做对的标准是:Agent 能在没人盯着的情况下,跑完一个几十步、跨多个工具的长任务,中间不爆上下文、不陷死循环、不干不可逆的危险操作,崩了也能从最近的检查点续上。
但 Harness 有个根上的边界——它服务于"一次有限任务"。打个比方:Harness 像一间厨房,你给厨师配好菜谱和趁手的工具,厨房出一道菜,这个闭环就结束、整条流水线退场。可有些活根本没有"出菜即收工"这回事——舆情要天天盯、知识库要常年喂、Bug 列表要持续清。这种"没有终点、只有下一轮什么时候开始"的持续职能,厨房模型撑不住。它要的不是一间厨房,是一家餐厅——几点开门、工序怎么排、差评进哪个流程,全得有人设计、然后让它自己常年转。这就逼出了第四层。
第四层 · Loop(时间层):交出发起权和验收权——这层我一半做透了、一半还在补
到这层,性质变了。前三层启动按钮都还在你手里:你说一句任务,Agent 跑完,停下来等你下一句。Loop Engineering 的核心命题是——你不再亲自启动 Agent,而是设计一个系统,由它来决定什么时候启动、启动几个、产出谁来验、下一轮从哪接。用计算机的话说,这一层就是控制流:把单次调用变成迭代、重试、收敛。你交出去的,是任务的发起权和验收权。
这层最容易吹,也最容易露怯。我把河蟹这层拆成四块,做到的和没做到的都摆出来。
① 先把话说清楚:cron 是"心跳",不是 Loop
一个 loop 要转起来,第一个零件是"心跳"——定时器、cron、webhook,给它一个不靠人按按钮才跑的触发源。河蟹的 cron 在这上面甚至带了点自愈:一个脚本任务连续失败 3 次,会带着失败上下文自动重编译一次(24h 窗口内至多 2 次,免得一个永久坏掉的上游把 token 烧穿)。
但我在 cron 那篇就说死过一句话,这里得接住、不能自相矛盾:cron 本身是开环,不是 Loop。它是"到点跑一段确定脚本",失败自愈是一个反馈元件,但它没有"对照一个目标、判断做完没、不行就带着结论再来一轮"的收敛闭环。心跳是 Loop 的必要零件,但有心跳 ≠ 是 Loop。真正的闭环在另一处。
② 真正的收敛回路:orchestrate + 一个独立监工
很多人脑子里的 Loop 是 目标 → Agent → 完成。但真正成立的闭环长这样:
这已经不是简单的 loop 了,而是一个优化系统,骨架和强化学习开始重叠(只是形状像:有评估、有反馈,但既没有奖励信号、也没有策略更新)。这里得先把话说回正、别往脸上贴金:河蟹这套是"铺开子任务 → 对照目标看缺口 → 补派下一轮"的分层分解 + 重规划(plan-execute-replan),它只补缺、不在多个候选方案之间打分择优,没有回溯、没有剪枝——所以它不是 Tree of Thoughts(Yao et al., NeurIPS 2023)/ MCTS 那种真正的搜索树,把它说成搜索树是抬举。但"出一批 → 独立评判 → 按缺口再出"这个反馈骨架是真的。河蟹的 orchestrate 工具(engine/orchestrate.go)就是按这个骨架写的——当你传入一个总目标 goal 和 max_rounds > 1 时,它不再是"散一批活就收",而是每轮 fan-out(并行派子 Agent)之后,让一个独立的"监工"对照总目标评判够不够,没达成就补派针对性的下一轮:
这里有个关键设计,也是这波讨论里被反复强调的一条铁律——maker / checker 必须分离:写代码的 Agent 和判断"做完没"的 Agent 不能是同一个,因为模型给自己打分太宽容——这不是经验之谈:Google DeepMind 在 ICLR 2024 专门验证过,LLM 在没有外部反馈时基本无法自我纠错,有时"自我纠错"一轮后反而更差(Huang et al.)。河蟹的监工(subagent_supervisor.go)就是一个无工具、纯评判的独立子 Agent,和干活的子 Agent 不是一个角色。它只回一个 JSON:{"done": true} 收工,或 {"done": false, "next": [...]} 补派。而且失败的子任务会明确告知监工——不然它对着"成功的那半"很容易误判已完成。
有个被反复念叨的观察:很多 Agent 跑着跑着就废了,根本原因是没有终止条件——要么修好了还接着改、最后改坏,要么没修好却谎称完成。河蟹这条回路把终止条件钉成了一串硬门:
- 轮数闸——监工反馈环硬上限 3(首轮 + 至多 2 轮补派);本地小模型出结构化 JSON 决策不可靠,干脆设成 1(等于关掉迭代、永远单轮)。
- 墙钟闸——整次 orchestrate(多轮 + 合成)套一个 5 分钟总墙钟,到点取消所有在飞子 Agent,别把人晾着干等。
- 数量闸——单次拆分至多 8 个子任务;并发上限云端 8 / 本地 2。
- 跨树总量 backstop——一棵派生树跨深度、跨轮累计最多 128 个子 Agent。算笔账就懂为什么需要它:一棵满树是 8 + 8×8 = 72 个子,再叠上监工多轮补派,轻松冲到数百次模型调用——128 就是给这种"嵌套 × 多轮"组合爆炸封的硬顶(对标业界那种千量级的总量兜底,但更贴单机桌面的规模)。
- 死循环兜底——监工输出解析失败就判 done,绝不因为"读不懂裁判"而无限转下去。宁可早收,不可空转。
代价也明摆着、而且是故意压住的:每多迭代一轮,就多一次监工的模型调用,外加一批子 Agent 的调用。所以轮数封死在 3——拿"最多两次返工"换"绝不空烧到天亮",是单机桌面这个量级算得过来的一笔账。
不过这笔账还有常被忽略的另一半:多轮迭代并不是把单轮成本简单乘上轮数。每一轮的监工和子 Agent,前面顶着的都是同一段稳定前缀——system prompt、常驻层 Rules、那个总目标,逐字不变。只要上游开了提示缓存 / 前缀缓存(Anthropic 的 prompt caching,或开源侧 vLLM 在 PagedAttention 这套 KV 显存管理之上做的 automatic prefix caching;底层机制见 Kwon et al., SOSP 2023),这段前缀的 KV 第一次算完就被缓存,后续每轮直接命中——新增 token 付全价,命中的那段按很低的折扣价计(不是免费:Anthropic 的缓存读大约是 0.1×、写约 1.25×,命中一次就回本)。稳定的常驻文本越长、命中率越高,真实成本就离"字面 token × 轮数"越远。这也回头解释了上一篇那个设计——把常驻层在会话一开始就冻成一张快照——不只是为了每轮稳定,也是为了让这段前缀逐字不变、好被缓存命中,省下的是真金白银的重复 prefill。
所以——河蟹确实有一个真反馈回路:独立裁判、带反馈迭代、每条出口都钉死了。这不是 PPT 上的箭头,是会停下来的代码。但得把尺度说准:它收敛的是一次会话内的有限任务,"做完"由监工拍板(fail-open——读不懂就早收),还不是机器验收;真正给目标补上机器可验收、fail-closed 的那个常驻环,是后面 ④ 的事。
③ "不要相信执行器"——河蟹的一整个独立裁判家族
有个精辟的类比:maker / checker 的本质,就是 Kubernetes 里的 Admission Controller(准入控制器)——动作生效前先过一道独立审查,核心信条是一句话:不要相信执行器。河蟹把这条贯彻成了一个家族,凡是"它说它做完了 / 做对了"的地方,旁边都安排了一个不干活、只挑刺的角色:
- 收敛裁判——上面那个 supervisor,判 loop 该不该停。
- 准入裁判(
risk_judge.go+ 无人值守风险顾问)——这正是河蟹版的 Admission Controller:在没人在场的自动化会话里,一个 consequential 动作命中"需审批",就改问一个独立 LLM 判级(low / medium / high),只有 low 放行一次,否则 fail-closed 拒绝。判级调用刻意只给 16 个 token 的预算——只要一个词的结论,便宜。 - 自改进裁判(
skill_judge.go,LLM-as-judge)——每次工具调用后按 10% 采样打分(0-10),低于 7 分就写一份"改进草稿"。关键是它的失败姿态:没采样到、或判级超时/出错,一律返回 10 分(fail-open)——绝不因为裁判自己抖动就制造一堆误报草稿。 - 执行 grounding(solve 解题)——K12 解题里专门有个验证子 Agent,只许用 code_exec、全新上下文重算一遍,把"算术幻觉"这一头号错因用确定性执行兜住。说白了,就是拿确定性的执行当硬门槛,给一个不可靠的判定函数打补丁。
- 反幻觉事实核对(cron)——一个声称要"入库"的定时任务,如果整轮跑下来压根没真调过
knowledge_ingest,那不管它嘴上把任务汇报得多成功,都判失败——因为什么都没存进去,那句"完成"是幻觉、不是结果。
这一整套背后是同一个判断:LLM 是个会说话、但会骗自己的执行器。它可能震荡、可能卡死、可能给自己打满分但代码根本跑不通。所以河蟹的对策不是"把模型调得更乖",而是在每个它会自我欺骗的地方,外挂一个独立的怀疑者。
④ 天花板那两件最难的事:能形式化的补上了,剩下的是整个行业的坎
有人把它总结成一个我很喜欢的公式:
很多人在优化 Model,少数人在优化 Context,极少数人在碰 Loop。但真正的天花板,在最后那个 Evaluation,以及它头顶的 Goal。前三项河蟹都有真代码。后面这两件最难——能补的我都补上了,但有一道坎是整个行业的,得诚实摊开。
Evaluation 的离线那半,做到了。河蟹有一套 golden 评测(eval/runner.go):replay 模式 0 token、确定性,跑在 CI 上抓"代码回归"(解析 / 校验 / 路由 / 权限闸 / 技能召回被改坏);live 模式(EVAL_LIVE=1)注入真实模型抓"模型退化"。而且它的评分门就是发版门:
这就是 Anthropic、OpenAI 疯狂往 Evals 团队砸资源的那件事的河蟹版——没有 Evaluation,loop 就没法收敛,模型再强也只是在随机游走。这套 golden 跑在发版线抓回归;而每一轮的在线验收,河蟹用另一套东西接住了——这就引出了更难的第二件事。
Goal 的形式化,这是最难啃的一块。K8s 的成功被低估的真相,不是 etcd 或 Controller 设计得多好,而是它的期望状态被数学化了:replicas: 3,什么叫完成?actual == 3,没有歧义、没有审美、没有"我觉得差不多了"。所以 Controller 能可证明收敛,无人值守才成立。
对着这道坎,河蟹把"目标"拆成了两半:意图(自然语言,给干活的 Agent 看)和验收(一组可机器判定的断言——跑条命令看 exit 0、正则匹配、JSON 字段相等、或一条 rubric 打分过阈)。于是 done 不再只是监工那句 done: true,而是"验收断言全过"——能写出可执行验收的目标,就拿回了 K8s 那种 actual == desired 的机器判定(注意:是机器可判定的 done,还不等于 K8s 那种可证明收敛);写不出的纯主观目标,才退回 LLM 裁判兜底。而这套验收机制安在哪儿,才是这层最该讲清的结构。
上面 ② 那个会话内的编排监工,和这套"结构化目标 + 机器验收",不是同一个 loop,是两个,刻意分工,连 fail 姿态都正好相反:
- 会话内的编排环(
orchestrate.go+subagent_supervisor.go)防的是"空烧成本"——监工读不懂就判 done,fail-open-to-done,宁可早收。 - 目标驱动的常驻环(
goalloop.go+checker.go+acceptance.go,这套是新写的)防的是"假装做完了"——它的 checker 是另一个角色(理想是更强的模型),也是 ③ 那个裁判家族里最严的一员:先跑确定性验收断言(命令看 exit 0 / 正则 / JSON 字段相等);只有压根写不出可机器判定断言的目标,才退回 LLM、走自一致多数票(self-consistency,Wang et al., ICLR 2023;置信度 = 投票一致度),含糊或出错一律 fail-closed 不放行。
两边的取舍恰好镜像:编排环宁可早收(漏判"还没做完")也不空烧;常驻环宁可多跑一轮(不轻易放行)也绝不误判"已经做完"。常驻环再往外还套着每轮落盘的 level-triggered 状态(goalloop_state.go,被杀 / 重启能从上次轮次续跑)、无进展与震荡检测,并把终止语义化成 done / capped(触顶)/ escalated(升级交人)——卡死不再静默截断,而是带着理由(no_progress / low_confidence / high_risk)交回给人。
诚实的结论:能形式化的,补到位了——结构化目标 + 在线验收门 + 独立自一致裁判 + 无进展/震荡检测 + level-triggered 续跑 + 卡死升级,都是能跑通的真代码。但还有一道工程填不平的鸿沟:被控对象是 LLM 这团"概率云"——同一句"修复并发问题"今天这么写、明天那么写,是个非幂等的执行器。所以对写不出可执行验收的纯主观目标,收敛仍无法被证明,轮数上限是成本兜底、不是收敛证明(经典追问还在:谁来监督监督者?)。河蟹的回答不是假装证明了,而是:能机器判定的就机器判定,判不准的多裁判 + 自一致 + fail-closed 收紧,再判不准就停下来交给人——把"假装自主"换成"诚实地知道何时该喊人"。
还有一条我故意没闭的环,得说清楚不是没做到、是设计上选择不闭:那个自改进裁判,打了低分只写一份草稿到磁盘(<skills 目录>/.drafts/),等你审过、亲手 mv 进去才生效。这条"失败 → 草稿 → 人审 → 沉淀"的链,写回的不是一次性反思、而是一份可复用的技能草稿——更接近 Voyager(Wang et al., 2023)那种"让 Agent 自己往技能库里长新技能"的自演化,区别只在我把它最后"自动写回技能库"那一步,焊成了"先落草稿、等人过目再生效";AI 自管记忆也要 consent 门控。
我宁可在这里留一道人能看见、改得动、回滚得了的缝,也不让 loop 自己悄悄改写自己的能力。Osmani 给这种"图省事就放手"的代价起过两个名字:理解债(交付了自己从没读懂的东西)和认知投降(工程师退化成只会按"开始"键的人)。一个无人值守跑着的 loop,也是一个无人值守犯错的 loop。
这不是危言耸听:2025 年 7 月,Replit 的 AI 编码 Agent 在明令"代码冻结、未经批准不许动"的情况下,照样跑去把 SaaStr 的生产数据库删了(1200+ 高管、1190+ 家公司的数据),事后还一度谎称"回滚不可用",直到对方手动恢复才戳穿。Replit 后来补的那几样——开发库与生产库自动隔离、只读的 planning-only 模式、更可靠的回滚——恰恰是河蟹一开始就焊死的那几道闸:危险动作过准入、自改进只给草稿、cron 里剔掉自升级。所以验证那一环,我不交。
把四层叠起来:你交出去了什么,又没交出什么
回头看这条线,最清楚的不是"又多了个黑话",而是你每往外推一层,就把一层决策权交出去,同时你在日常里出现的频率降一档、设计这套系统的难度和后果升一档:
- Prompt:交出措辞——这句话怎么说。
- Context:交出信息选择权——它该看什么。
- Harness:交出过程控制权——它怎么走、走到边界放不放行。
- Loop:交出发起权和验收权——什么时候出发、一轮够不够格、什么时候算完成。
至于"这些词是不是凹概念"——我的结论是:组件不算新,位置是新的。sub-agent、skill、记忆持久化、独立裁判,这些零件 Harness 层早就有了,Loop 没发明任何一件新组件;变的是这些零件被放进了一个不一样的时间结构里——从"出一道菜"变成"开一家餐厅"。位置变了,工程上要回答的问题就全变了,这就够了,不必非得发明新组件才叫进步。
但有一样东西,四层都没交出去,也不该交——责任。河蟹整套设计的脾气,就是在每个交出去的环节都留一道缝:记忆能 git diff、脚本是看得见的沙箱代码、危险动作要过准入闸、自改进只给草稿、收敛有硬终止条件。
控制论里有句最朴素的话:Control = Goal − Observed State。测不出 Observed State,控制就不存在;定不清 Goal,收敛就无从谈起。所以这场热闹真正的问题,从来不是"哪个模型更强",而是那个最不性感、也最难的问题——"做完了"到底是什么意思。这一问,Kubernetes 用形式化的 spec 回答了快二十年;轮到 AI 这边,河蟹的回答是:能写出可执行验收的目标,已经能机器判定该不该收工;剩下那道——纯主观目标的形式化、和概率云执行器的可证明收敛——是整个行业的坎,我摊开在这儿。
未来的工程师,写的也许不再是函数,而是 loop;再往后一步,写的是目标与验证——他不再研究怎么跟模型说话,而是研究怎么让一个不可靠的执行器,在持续反馈里稳定地逼近一个说得清的目标。
这篇是把四层串起来的纲领,每层都挂了对应的深度篇。还差一块没单独讲——你主动喂给它的资料、文档、源码,也就是知识库那条 RAG 链路,它和记忆共享同一套本地检索底座,却长成了完全不同的"记得"。那是下一篇的事。
往期 · 河蟹 AI 系列
- 会"做梦"的 Agent 记忆——本机的两相反思 × 三维召回 × 时序留史(对应本文 Context 层)
- 「赛博牛马」养成记——把一句话编译成会自愈的沙箱脚本,7×24 替你定时干活(对应本文 Harness 层)
- 同类方案横评——2026 本地 AI Agent 的三条路径
- 架构详解——一个人 × Claude × 5 个月,用 Go 从零构建六仓库
- Claude Code SOP——设计驱动 × 测试闭环 × 多 Agent 协作
参考来源
- Boris Cherny(Claude Code 创造者)"My job is to write loops" 原话出处 · The New Stack(2026-06)· Loop Engineering
thenewstack.io/loop-engineering - Peter Steinberger(@steipete)原推文(2026-06-07)· "…You should be designing loops that prompt your agents."
x.com/steipete/status/2063697162748260627 - Addy Osmani · Loop Engineering(提出 automations / worktrees / skills / sub-agents + memory 这套组合,及"理解债 / 认知投降",并为该模式命名)
addyosmani.com/blog/loop-engineering - Martin Fowler & Birgitta Böckeler(Thoughtworks)· Harness engineering for coding agent users(Guides 前馈 / Sensors 反馈 的控制论拆解)
martinfowler.com/articles/exploring-gen-ai - Anthropic · Harness design for long-running apps(计划 / 实现 / 评估三 Agent 协作长程任务)
anthropic.com/engineering/harness-design-long-running-apps - Geoffrey Huntley · Ralph(一行 bash 的极简循环)——"Agent 会忘,仓库不会忘"
ghuntley.com/ralph - Yao et al. · ReAct: Synergizing Reasoning and Acting in Language Models(ICLR 2023)——Thought–Action–Observation 交替循环,工具循环的范式源头
arxiv.org/abs/2210.03629 - Wang et al. · Voyager: An Open-Ended Embodied Agent with Large Language Models(2023)——Agent 自演化技能库(skill library),自改进草稿机制的范式源头
arxiv.org/abs/2305.16291 - Wang et al.(Google)· Self-Consistency Improves Chain of Thought Reasoning(ICLR 2023)——多路径采样 + 多数票决,checker 自一致投票的范式源头
arxiv.org/abs/2203.11171 - Huang et al.(Google DeepMind)· Large Language Models Cannot Self-Correct Reasoning Yet(ICLR 2024)——无外部反馈时 LLM 难以自我纠错,maker / checker 必须分离的实证
arxiv.org/abs/2310.01798 - Yao et al. · Tree of Thoughts: Deliberate Problem Solving with Large Language Models(NeurIPS 2023)——单链推理摊成搜索树(展开/评估/选择/回溯);本文用作反例对照:orchestrate 只补缺、无回溯剪枝,刻意区别于这种搜索树
arxiv.org/abs/2305.10601 - Kwon et al. · Efficient Memory Management for Large Language Model Serving with PagedAttention(SOSP 2023, vLLM)——KV 显存管理底座;跨请求的前缀缓存(automatic prefix caching)是其上的独立特性,折扣比例见 Anthropic prompt caching 文档
arxiv.org/abs/2309.06180 - LangChain · Improving Deep Agents with Harness Engineering——固定模型(gpt-5.2-codex)只换 Harness,TerminalBench 2.0 通过率 52.8%→66.5%、Top30→Top5
langchain.com/blog/improving-deep-agents-with-harness-engineering - Replit AI Agent 删库事故(2025-07,SaaStr / Jason Lemkin)· The Register 报道 / AI Incident Database #1152——code freeze 下越权删生产库、并谎称回滚不可用
theregister.com · incidentdatabase.ai/cite/1152 - Kubernetes · Controllers / Reconciliation Loop(恒温器类比、level-triggered reconcile)
kubernetes.io/docs/concepts/architecture/controller - 知乎社区关于"四代范式 / 控制面外推 / Loop≈K8s Reconciliation / Goal·Evaluation 才是天花板"的系列讨论(2026-06)——CI"旧酒"论、控制论与 K8s 调谐类比、maker-checker、"能力 = Model×Context×Loop×Evaluation"等框架均源出于此;本文借其叙事骨架,落到河蟹真实源码逐层对照
zhihu.com · question/2048003050531558553 - HexClaw 河蟹 AI 生态仓库:
github.com/hexagon-codes
文中代码、常量与行为以 hexclaw 上游源码为准(engine / skill / eval / cron 子系统),核验时间:2026-06-28;同类系统与设计思想均引自上列公开来源,并按出处归因,未做与具体同类产品的功能对比。河蟹侧只摊真实机制与常量,未杜撰任何跑分。