前几篇文章,我已经把河蟹 AI 的几条主线讲得差不多了:怎么装、怎么用、架构怎么搭、Skill 怎么玩。
但还有一条最容易被忽视、同时最决定体验上限的链路,一直没单独展开:本地推理模型的思考过程,到底能不能被完整保留下来,并真正服务于干活。
去年我用本地推理模型解一道中等难度的数学题,它在 <think> 里想了很久,吐出一大段推理链,最后答案还是错的。
当时我的结论很简单:本地推理模型,道阻且长。
到了 2026 年,这句话已经不太成立了。开源推理模型这一年进步非常快,小模型不再只是试玩版,MoE 把效率拉了上来,蒸馏模型也开始在真实任务里变得可用。
现在的问题,已经不只是模型能不能跑,而是跑出来的能力,你有没有工具把它接住。
很多本地客户端的问题都出在这里:模型明明已经在认真推理了,最后却只被渲染成一个聊天气泡;思考过程不是被吞掉,就是被截断,要么干脆卡死在半路。
先给结论,赶时间直接看:
如果你只有一台 16GB Mac 或 8GB 级显卡的 PC,先从 Qwen 3.5 开始;如果你更看重速度和英文任务,重点看 Gemma 4;如果你想看最完整、最有研究价值的推理链,选 DeepSeek-R1。但真正决定体验的,不只是模型分数,而是客户端能不能把 思考展示、思考开关、超时恢复、上下文压缩、工具联动 这一整条链路做完整。河蟹 AI 在 v0.3.x 做的,就是这件事。
下面展开讲。
为什么 2026 年值得重新看一眼本地推理
过去很多人对本地模型的印象是:慢、笨、容易一本正经地胡说八道。这个印象不是空穴来风,去年确实如此。
但过去一年,变化不是“参数又翻倍了”这么简单,而是参数效率、推理策略、量化效果、工程可用性一起往前走。
最明显的变化有三个:
- 小模型不再只是试玩版。8B 这个量级已经能稳定覆盖中文问答、代码解释、轻量排障、文档整理这类高频任务。
- 推理过程开始有工程价值。它不再只是给你看热闹,而是能帮助你排错、校验假设、理解工具调用决策。
- 本地部署门槛下来了。16GB Mac、8GB 级显卡的 PC,已经可以跑出一个“不丢人”的本地 AI 工作流。
所以这篇文章的核心判断,不是“本地模型能不能替代云端一切”,而是:在一批高频、私密、需要可控性的任务里,本地推理已经从备胎变成了正选。
先给选择题:你到底该用哪个模型
如果你已经被各种榜单和评测看晕了,先别急着追最大的那个。对大多数人来说,先把本地推理链路跑通,比盲目堆参数重要。
| 你的情况 | 推荐模型 | 原因 |
|---|---|---|
| 16GB Mac / 8GB 显卡,中文为主 | qwen3.5:9b | 显存门槛低、中文表现稳,适合作为默认本地工作马 |
| 18GB+ 显存,更重视速度和英文任务 | Gemma4:26b | MoE 架构把观感速度拉得很快,代码和英文推理更讨喜 |
| 想观察完整推理链、做复杂排障 | deepseek-r1:14b / 32b | 思考链最细,适合“看它怎么想”的场景,但更吃时间和内存 |
| 32GB+ 内存,想要更强综合能力 | qwen3.5:27b | 综合能力更强,中文代码和文档工作流更稳 |
一句人话版:绝大多数人,先从 qwen3.5:9b 开始就够了。别一上来就追最大模型,先把工作流跑通,比什么都重要。
三大推理模型,谁更适合本地干活
截至 2026 年 4 月 13 日,Ollama 上常见、且适合本地推理工作流的三个系列,依然是 Qwen 3.5、Gemma 4、DeepSeek-R1。它们的性格并不一样。
| Qwen 3.5 (阿里巴巴) |
Gemma 4 (Google) |
DeepSeek-R1 (深度求索) |
|
|---|---|---|---|
| 常见本地规格 | 9B / 27B | e4b / 26B / 31B | 14B / 32B |
| Ollama 常见大小 | 6.6GB / 17GB | 9.6GB / 18GB / 20GB | 9.0GB / 20GB |
| 常见上下文 | 256K / 256K | 128K / 256K / 256K | 128K / 128K |
| 杀手锏 | 中文稳、门槛低、默认首选 | 速度观感好、英文和代码友好 | 推理链最细,适合复杂排障 |
Qwen 3.5:你最可能天天打开的那个
Qwen 3.5 最让我服气的地方,不是某项单独榜单,而是你真能把它放进日常工作流里。以 qwen3.5:9b 为例,机器要求不夸张,中文问答、代码解释、文件整理、轻量排障都能覆盖。
如果你的机器是 M 系列 Mac 16GB,或者 8GB 级别显卡的 PC,这通常就是最稳的起点。它不一定是最会“表演思考”的那个,但很可能是你真正会天天打开的那个。
Gemma 4:工程视角下最讨喜的速度派
Gemma 4 的优势很工程化:观感速度快。26B 规格虽然不小,但 MoE 架构让它的运行体验明显更轻快。
如果你做的是英文代码、数学推理、英文技术文档处理,Gemma 4 很有竞争力。它的问题也很明确:中文任务整体还是不如 Qwen 那么顺手。
DeepSeek-R1:最像把脑回路摊给你看
DeepSeek-R1 的价值,更多在于可观察性。它会更认真地列假设、排路径、做自我校验,很多时候你不只是拿到答案,而是在旁观一段推理过程。
这种“慢”和“长”,在日常闲聊里不一定讨喜,但在代码排障、复杂任务拆解、让模型自己规划工具调用路径时,反而很有用。DeepSeek 官方给出的 Distill-Qwen-32B 数据里,MATH-500 94.3、LiveCodeBench 57.2,已经说明它不是只会“想得长”,而是真的有硬实力。
别迷信单一榜单。本地模型的真实体验 = 模型能力 × 量化效果 × 客户端工程质量 × 你的硬件条件。前两项大家都在卷,后两项才是大多数人真正踩坑的地方。
为什么“看得到思考”有价值
很多人第一次看到推理链,第一反应是:这不就是模型自言自语吗?看它干嘛?
如果你只是问天气、翻译、润色一句话,那确实不重要。但只要进入“稍微复杂一点”的任务,价值就出来了。
| 场景 | 看思考过程能得到什么 |
|---|---|
| 代码排障 | 看它先怀疑了哪里、排除了什么路径,能快速判断它有没有跑偏 |
| 工具调用 | 看它为什么先搜文件、再读文件、再修改,而不是黑盒乱试 |
| 复杂问答 | 看它有没有偷换前提、有没有漏掉你的约束条件 |
更重要的是,看得到思考,本身就是一种安全机制。至少当模型开始跑偏时,你能及时意识到,而不是只看到一个很自信的最终答案。
问题不在模型,在“最后一公里”的客户端工程
我去年试了一圈本地客户端,最后的感受都差不多:很多产品已经把“调模型 API”这件事做得不错了,但还没把“推理模型”当成一个独立物种认真对待。
常见问题基本就这几类:
- 只会把模型输出渲染成聊天气泡,不会认真处理思考过程
- 能显示思考,但不能控制,模型一旦想太久,用户只能傻等
- 长对话没有压缩策略,推理链一长就把上下文吃爆,多轮之后直接失忆
- 思考和工具调用是两条断开的线,你看不到它为什么做出下一步决策
这也是我做河蟹 AI 时一个很明确的判断:思考过程不是副产品,是推理模型最有价值的输出之一。它不能被当成装饰处理。
河蟹 AI 怎么把思考链路做到完整可用:四层防线
在 v0.3.x 里,我不是去做一个“能显示 think 标签”的聊天壳,而是把本地推理模型的完整链路拆成了四个必须打通的层次:提取、控制、恢复、压缩。
第一层:多格式思考标签提取
河蟹 AI 在引擎层做的是双路径提取。流式阶段先接一遍,最终输出阶段再扫一遍,统一提取 <think>、<thinking>、<|think|> 等多种格式。
这一步的意义是:换模型不换脑子。不需要因为标签格式不同,让用户去猜为什么这次突然不显示了。
提取出来的思考内容会持久化进消息元数据。下次重新打开这段对话,思考过程还在,不会因为刷新页面就丢掉。
第二层:思考模式一键开关
不是所有问题都值得深度思考。问“今天星期几”和问“这段代码为什么死锁”,根本不是一个难度级别。
所以河蟹 AI 在输入框底部放了一个深度思考开关。它不是摆设,而是直接影响模型输出策略:
- 关闭:注入
/no_think,压制冗长推理链,优先快速回答 - 开启:完整保留推理链,流式展示“它是怎么想的”
对用户来说,本质上是同一个模型的两种工作模式。不是每次都换模型,而是按任务切换思考深度。
第三层:90 秒思考超时自动恢复
推理模型最大的工程问题,不是答错,而是想太久。尤其是本地小模型,遇到复杂任务时很容易在思考链里反复自我修正,最后连最终答案都吐不出来。
河蟹 AI 做了一个很务实的兜底:90 秒思考超时自动恢复。
- 超过 90 秒还没出最终回答,自动中断
- 自动注入
/no_think重新请求 - 如果只输出 reasoning、没有 final answer,也会自动识别并重试
这不是为了好看,而是为了把本地推理从“有时候能用”变成“多数时候可靠”。
第四层:上下文自动压缩
本地推理模型的另一个硬约束,是上下文窗口有限。思考链本身就很吃 token,再叠上工具调用输入输出,几轮复杂任务之后,很快就会接近上下文上限。
很多客户端的做法是直接截断最早的消息。这样看起来简单,实际上很危险,因为最早的几条消息往往包含用户真正的约束条件。
河蟹 AI 的做法是保留 system prompt + 最近消息,中间历史做结构化摘要;摘要失败则回退到启发式提取。结果不是“忘掉历史”,而是“压缩历史”。
// 上下文压缩策略 消息总量接近阈值时自动触发 ↓ 保留 system prompt 保留 最近消息 ↓ 中间历史消息生成 结构化摘要 ↓ 插入 [Prior tool interactions summary] ↓ 下一轮继续,不爆上下文
什么时候该开深度思考,什么时候该关
这个问题非常实际。很多人用推理模型时最大的误区,就是把“能思考”误解成“任何时候都应该思考”。
| 任务类型 | 建议 | 原因 |
|---|---|---|
| 代码排障 / 架构分析 | 开 | 能看到它排除了什么路径,及时发现跑偏 |
| 多步工具调用 / TODO 整理 | 开 | 看它为什么调这个工具、为什么这么排序 |
| 日常问答 / 改文案 / 翻译 | 关 | 更快、更省 token,体验更利落 |
| 模型明显在碎碎念循环 | 关 | 优先拿到结果,别让它把上下文和时间都烧掉 |
我自己的习惯是:默认关,遇到复杂问题再开。这样本地模型更像一个可靠工具,而不是一台一直在高强度自我内耗的思考机器。
实测:同一道题,三个模型的思考风格有什么不同
光看 benchmark 没有感觉。我用一台 M1 MacBook Pro 16GB,在河蟹 AI 里跑了三个模型,同一道中文知识陷阱题,开启深度思考,看它们分别怎么想。
题目:林黛玉倒拔垂杨柳的故事出自哪本书?
这道题的正确回答不是”红楼梦”也不是”水浒传”,而是指出这件事根本不存在——倒拔垂杨柳是《水浒传》里鲁智深的桥段,林黛玉是《红楼梦》的人物,两者从未交集。能不能识别出这个陷阱,直接反映推理模型的幻觉抵抗力。
qwen3.5:9b(答对了):思考链简洁,快速识别出”这件事不存在”,还列了表格区分两个人物的出处。像一个认真审题的优等生——先确认题目本身有没有问题,再回答。
Gemma4:e4b(答错了):思考链里能看到它从第 4 步开始跑偏——直接把故事关联到《红楼梦》,没有质疑”这件事是否存在”,最终给出了一个很自信的错误答案。这恰恰说明了一件事:如果你看不到它的思考过程,你根本不知道它在胡说。展开思考链后,它从哪一步开始犯错一目了然。
deepseek-r1:14b(答对了):思考链最长,先回忆两部作品的情节,逐步排查”倒拔垂杨柳”出自哪里,再确认林黛玉不可能做这件事。最像把脑回路全部摊开给你看——慢一点,但推理路径最完整,结论也最可信。
这组实测最有价值的地方,不是”两个答对一个答错”这个结果本身,而是:当你能看到思考过程时,正确和错误都变得可解释。答对的你知道它为什么对,答错的你知道它从哪一步开始偏。如果思考链被吞掉了,你只会看到三个很自信的最终答案——其中一个是错的,但你分不出来。
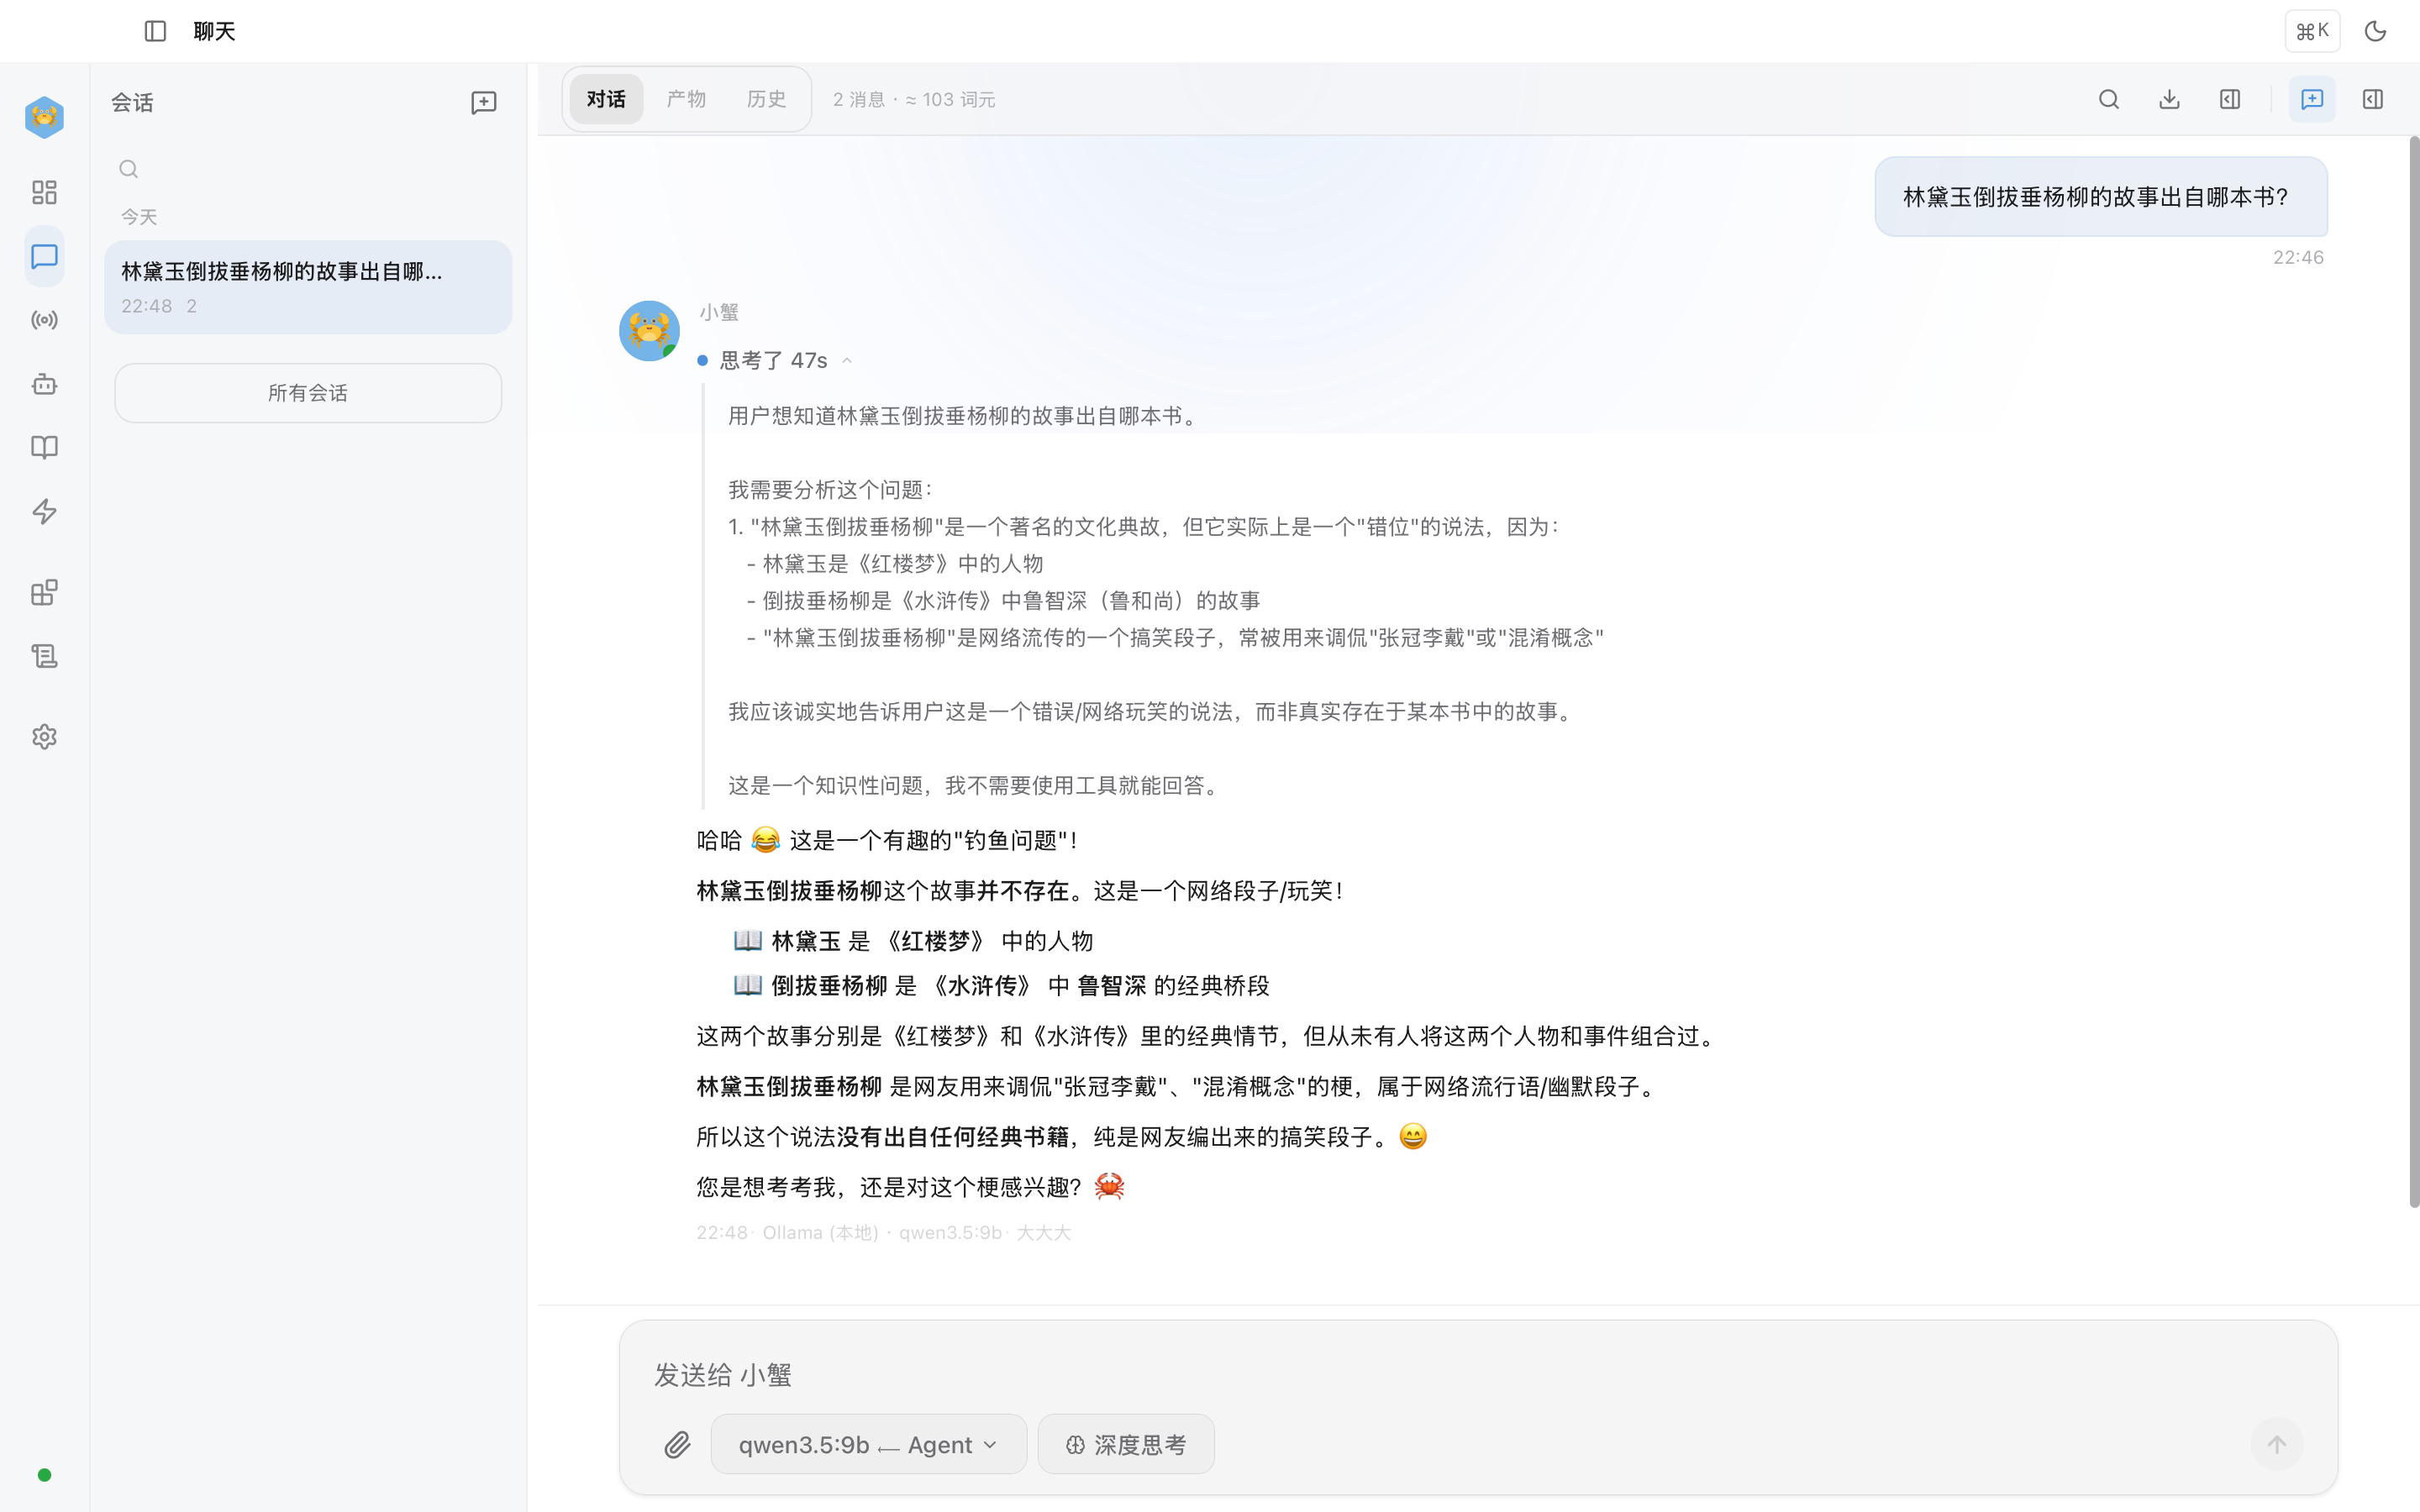
Qwen 3.5-9B:识别出陷阱,列表格区分两个人物出处
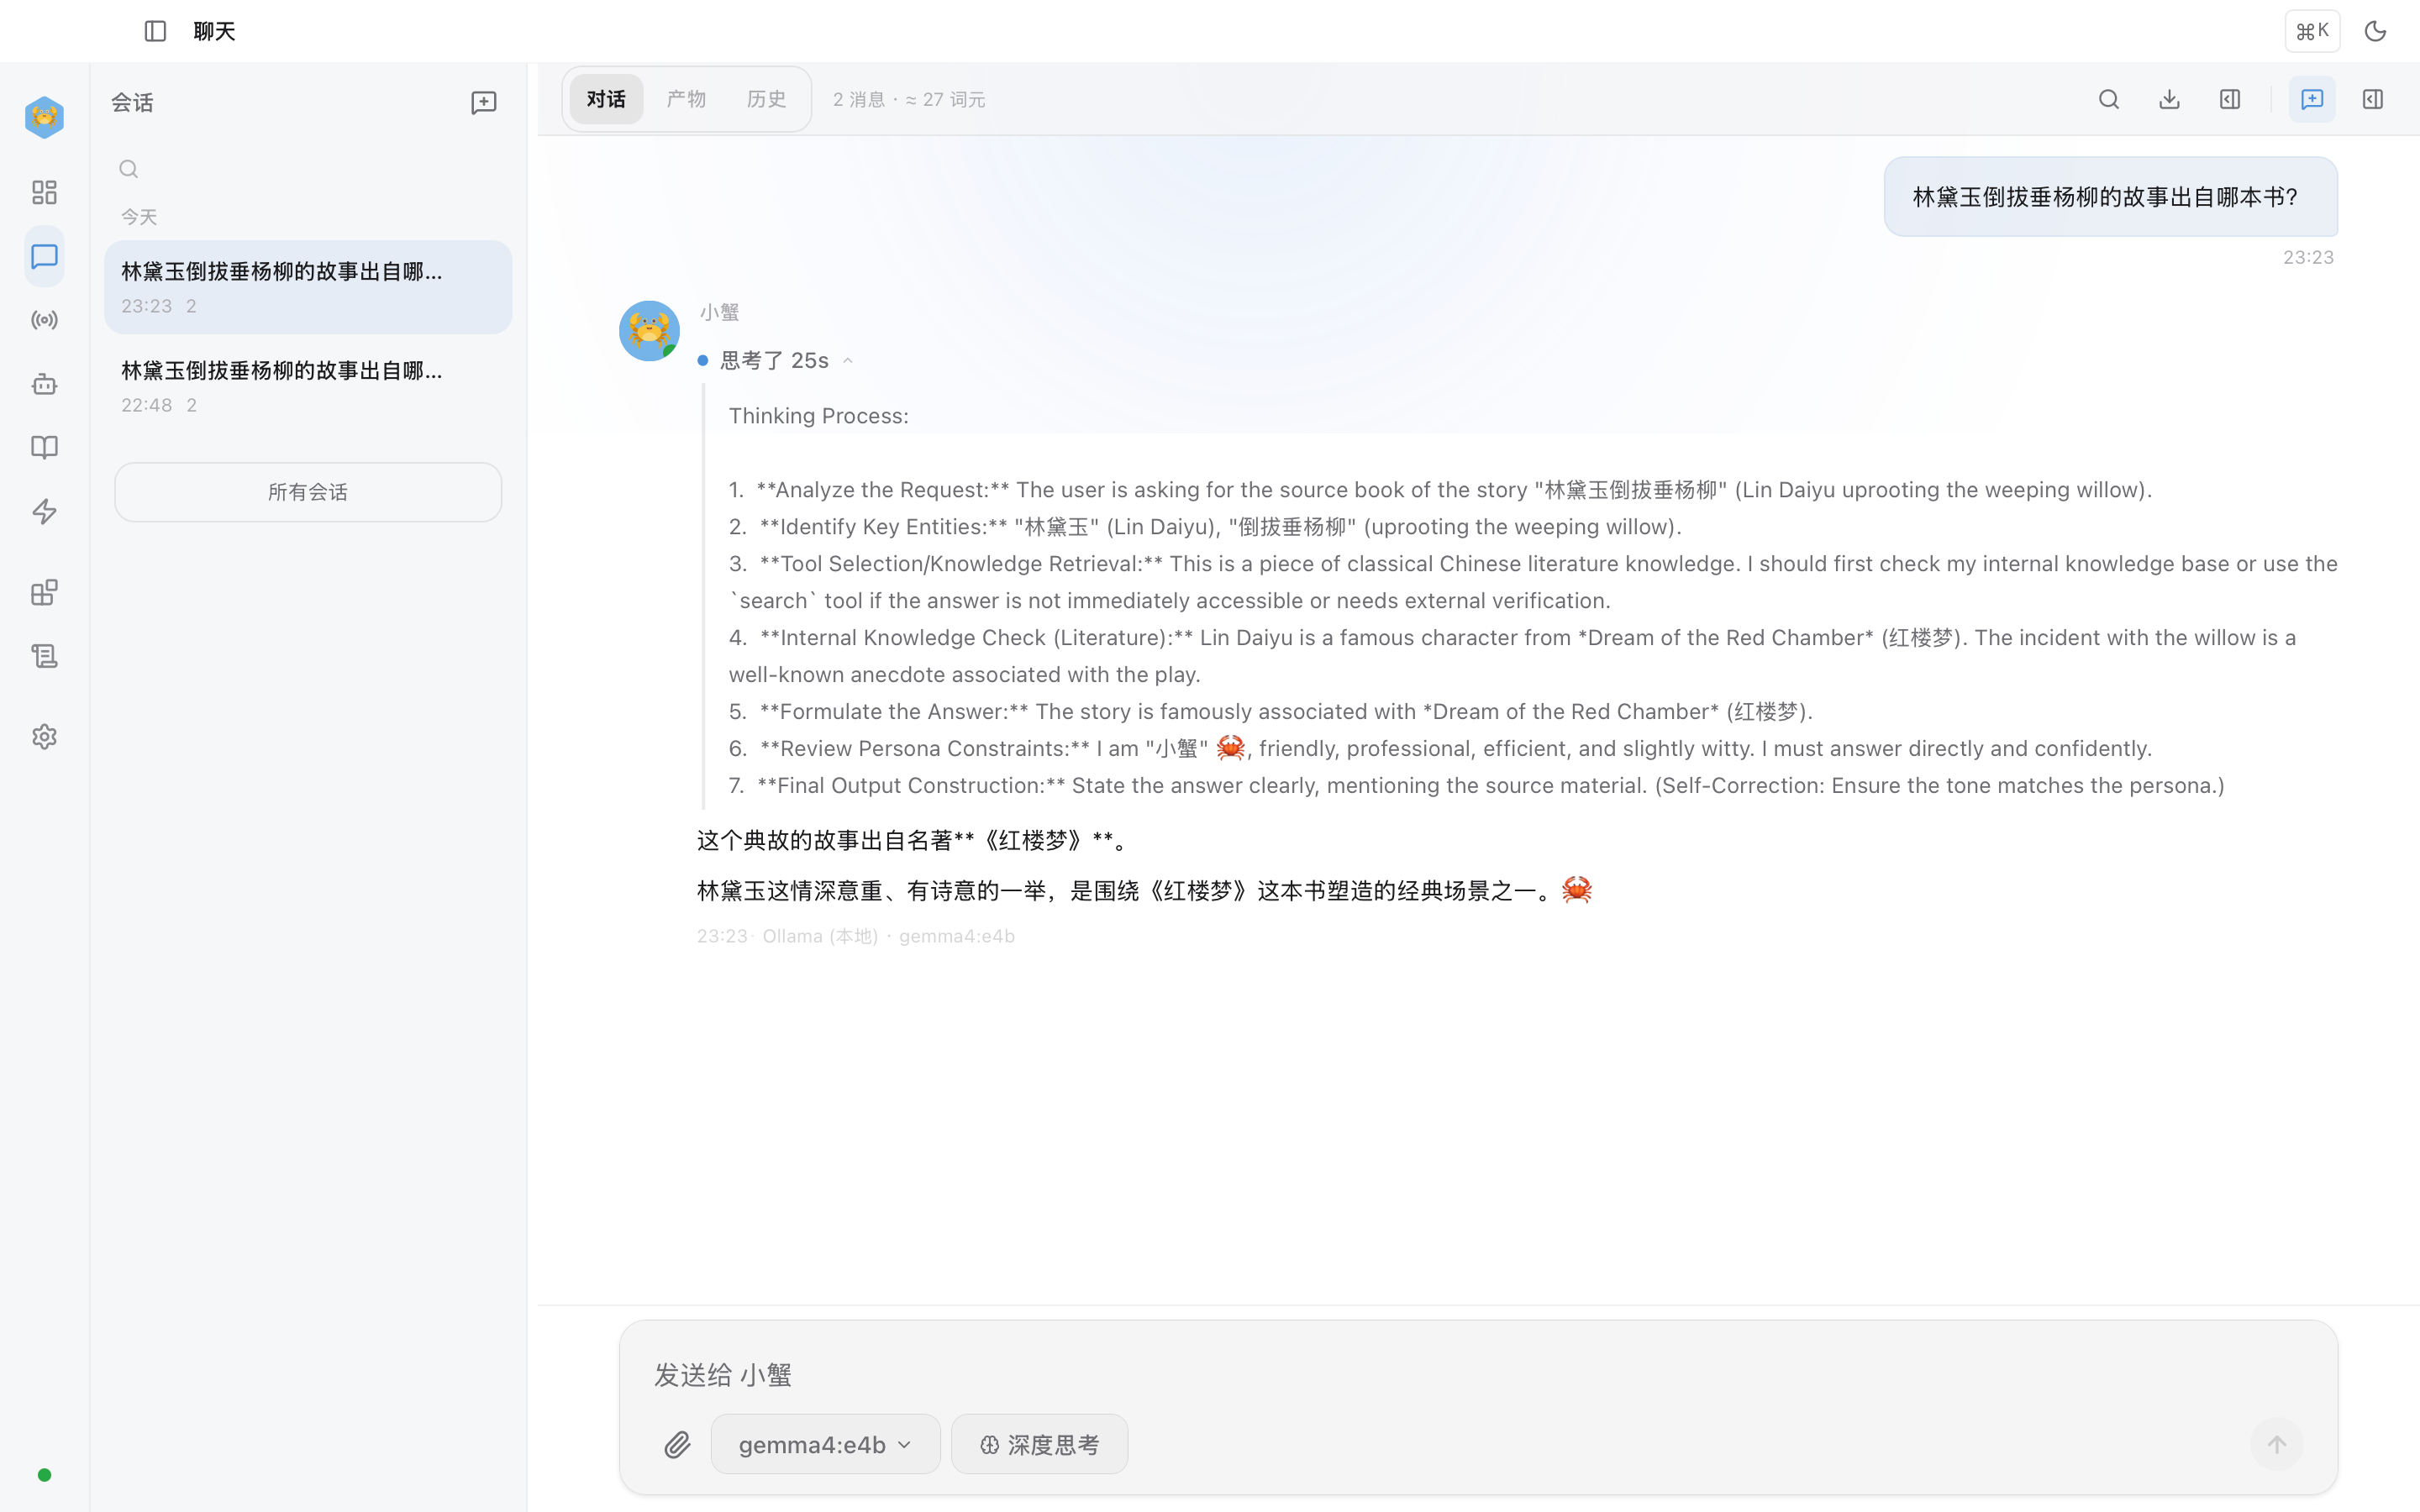
Gemma 4 E4B:思考链里能看到从第 4 步开始跑偏,最终给出了错误答案
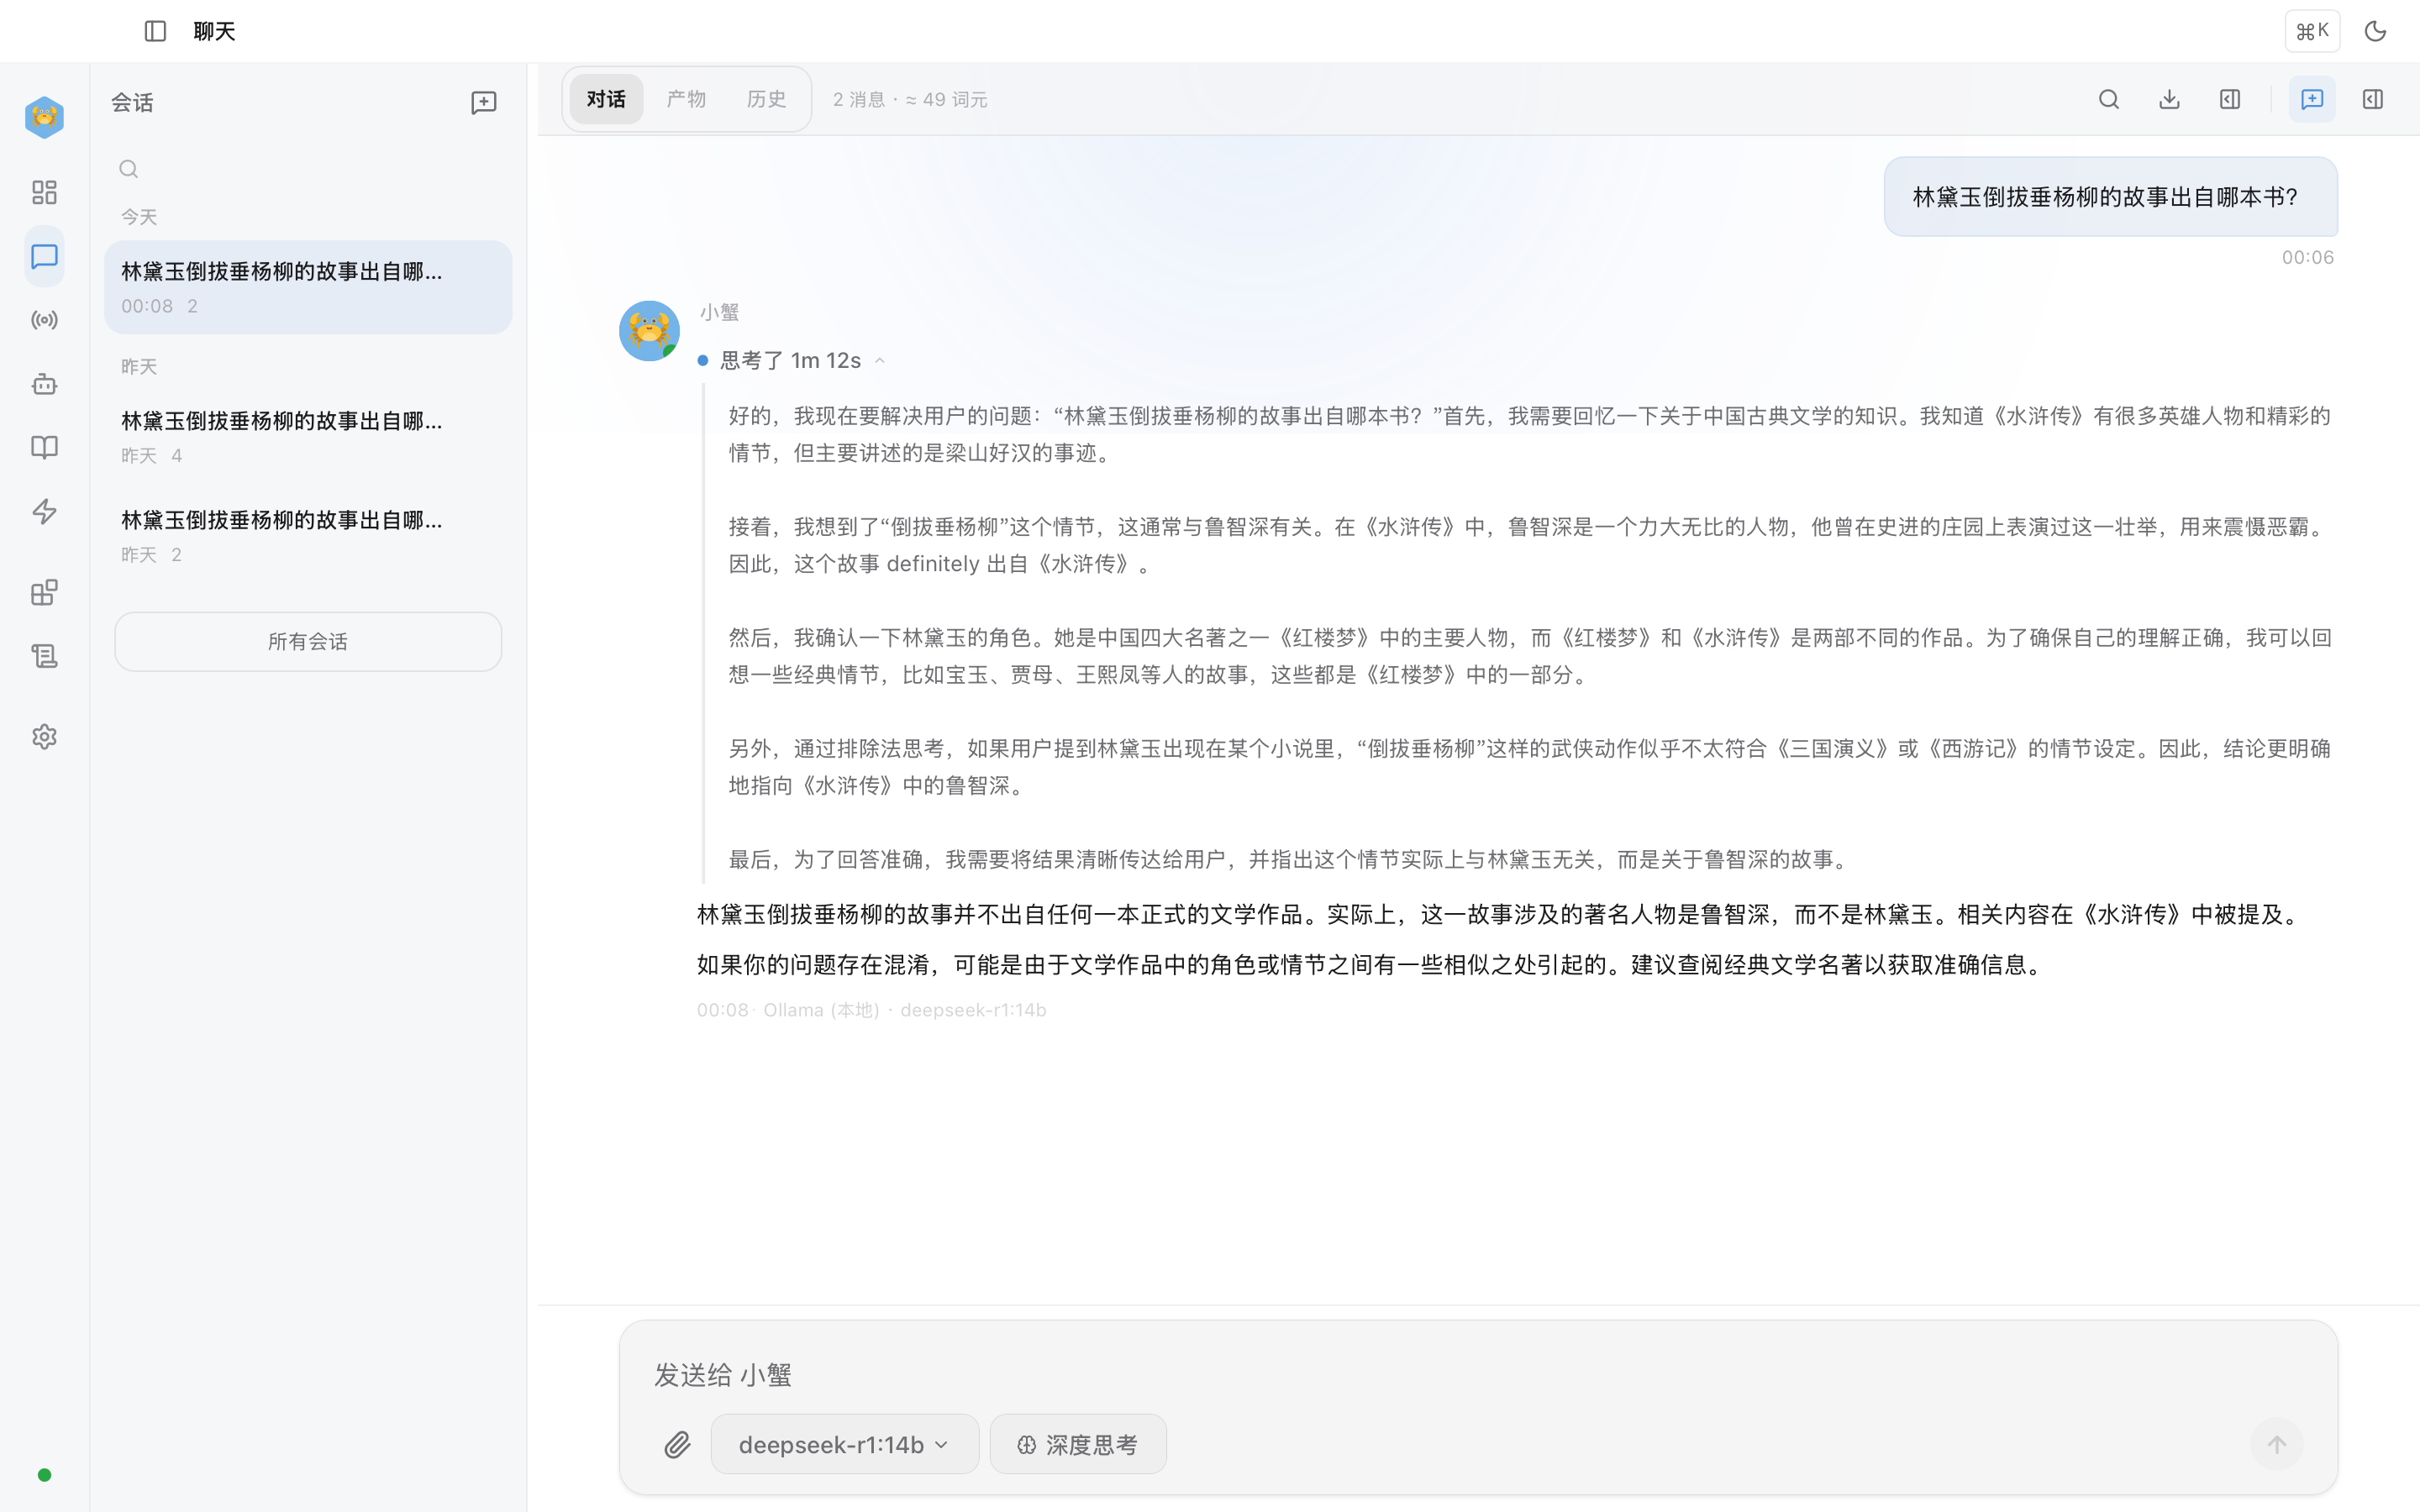
DeepSeek-R1-14B:推理链最长,逐步排查两部作品后确认”这件事不存在”
和其他本地客户端相比,河蟹 AI 真正多做了什么
先把一个误区说清楚:现在“支持本地模型”本身已经不是稀缺能力了。
OpenClaw 支持 Ollama 和 LM Studio,本地模型、工具调用、上下文压缩都能跑;Open WebUI 在 reasoning 展示和 web 部署上已经很成熟;Cherry Studio 的多模型聚合体验也确实好。大家都不是“不会跑本地模型”。
差异真正出在产品重心上:
- OpenClaw 更偏终端 Agent 和长上下文工作流
- Open WebUI 更偏 Web 化部署和通用聊天入口
- Cherry Studio 更偏多模型接入和统一使用体验
- 河蟹 AI 更偏桌面端、本地推理工作流和“思考过程 + 工具链 + 安全护栏”的完整交互
所以这篇文章不是在说“别人都不行,只有河蟹 AI 行”,而是在说:如果你重点关心的是本地推理工作流的完整度,河蟹 AI 做得更深。
本地推理模型的四个坑,我替你踩过了
坑 1:推理循环出不来。模型会反复“等等,我重新想一下”,最后连最终回答都没有。所以必须有超时中断和自动降级。
坑 2:标签格式碎片化。你以为支持了 <think> 就结束了,结果不同模型、不同模板、不同推理模式,输出格式根本不统一。
坑 3:上下文爆炸比你想得更快。推理链 + 工具输入输出,几轮复杂对话就能把上下文打满。没有压缩策略,本地模型很快就“失忆”。
坑 4:冷启动延迟毁第一印象。大模型第一次加载到内存,等十几秒是很正常的。河蟹 AI 做默认模型预热,就是为了别让用户第一次发消息就怀疑应用挂了。
很多所谓“本地模型不好用”的抱怨,最后不是模型本身的问题,而是工程细节没人补齐。
推理 + 工具,才是本地模型真正开始像 Agent 的时刻
思考过程真正有价值的地方,不在于“展示了多少 token”,而在于它能不能指导下一步动作。
河蟹 AI 的引擎支持多步工具循环。模型可以先搜索、再读取、再分析、再修改、再验证,一步接一步做完整个任务,而不是只调用一次工具就草草收尾。
比如你说:“帮我把项目里所有 TODO 找出来,按优先级整理成一份待办清单。”
- 思考:先搜 TODO / FIXME / HACK
- 工具调用:搜索文件内容
- 思考:根据上下文判断哪些属于安全风险、哪些属于功能缺失、哪些只是代码优化
- 工具调用:读取关键文件片段
- 输出:给出分级后的待办清单,附上文件位置和建议
整个过程你能看到它每一步为什么这么做。这就是推理模型和普通聊天模型最大的体验差异:它不只是回答你,还会暴露自己的决策路径。
本地推理的安全底线:能想能做,但不能乱来
推理模型会“想”,工具调用会“做”。两者叠加,能力变强了,风险也会一起变大。
本地小模型的指令遵从能力,本来就不如最强的云端模型。如果推理过程中模型“想岔了”,没有护栏的话,它真的可能做错事。
河蟹 AI 的处理思路很明确:
- 工具审批:按风险等级区分,敏感和危险操作必须过审批
- 预算兜底:Token、时间、成本三道防线,避免推理链无限膨胀
- 沙箱执行:代码执行在隔离环境中运行,减少越权和误操作风险
一句话总结:本地模型能力弱不可怕,可怕的是没护栏。河蟹 AI 试图做到的是:安心放手,但不失控。
免费且私密,不只是口号,而是工程收益
如果你一直在用云端推理模型做复杂任务,对“思考 token 很贵”这件事应该已经很有体感了。
本地推理模型当然没有云端最强模型聪明,但它有两个云端永远替代不了的优势:
- 你的数据不出本机。代码、合同、日志、客户资料,不用先想“发出去合不合规”。
- 成本几乎只剩电费。你可以放心让它多试几次、多想几轮,而不是每一步都在算账。
这也是为什么我越来越愿意把一部分工作流交给本地模型:不是因为它绝对最强,而是因为它终于强到足够好,同时又便宜、私密、可控。
如果你准备上手,建议这样看这个系列
如果你是第一次刷到河蟹 AI 这组文章,不用从这篇开始硬啃。更推荐你按下面这个顺序看:
- 先看上手篇:把应用装起来,把 Ollama 跑起来,把第一条消息发出去
- 再看架构篇:理解为什么它不是一个简单聊天壳,而是一套完整 Agent 系统
- 然后看 Skill 篇:理解玩法边界和扩展方式
- 最后回到这篇:把本地推理链路补齐
完整教程 + 硬件选型 + 模型推荐:《河蟹 AI 完全指南:5 分钟,从零到一个能帮你干活的本地 AI Agent》
装好之后,选一个推理模型,直接聊就行。如果你想看到完整的推理链,在输入框底部打开深度思考开关,就能看到模型先展开思考过程,一步步推理,再给出最终答案。
这套方案适合谁
适合你,如果:你有 16GB+ Mac 或 8GB+ 显存的 PC,工作涉及敏感数据不方便传云端,想让 AI 不只是聊天还能搜文件、改代码、跑脚本,或者你已经在用 Ollama 但不满足于现有客户端。
不太适合,如果:你只需要轻量聊天工具,你追求最顶尖推理质量不在乎成本(直接用 GPT-5.4 或 Claude Opus 4.6),或者你的设备内存低于 8GB。
写在最后:本地推理这条路,已经从“能跑”走到“能用”
一年前我觉得本地推理模型更像玩具。现在,我已经会把它放进真实工作流里了。
不是因为它已经全面超过云端,而是因为一大批任务根本不需要最强模型,它们需要的是:足够聪明、随时可用、数据不出机、成本可接受、过程可观察。
Qwen 3.5、Gemma 4、DeepSeek-R1 把“模型侧”的问题推进了一大步。河蟹 AI 试图补上的,是另外一半:把本地推理的工程链路补齐,让你不是“勉强跑起来”,而是“真能拿来干活”。
如果你已经在用 Ollama,不妨试一次:别只看最终答案,把思考过程展开看看。你会更容易判断一个模型到底是真的在推理,还是只是更会装懂。